AI 骨骼绑定对非常规生物没用
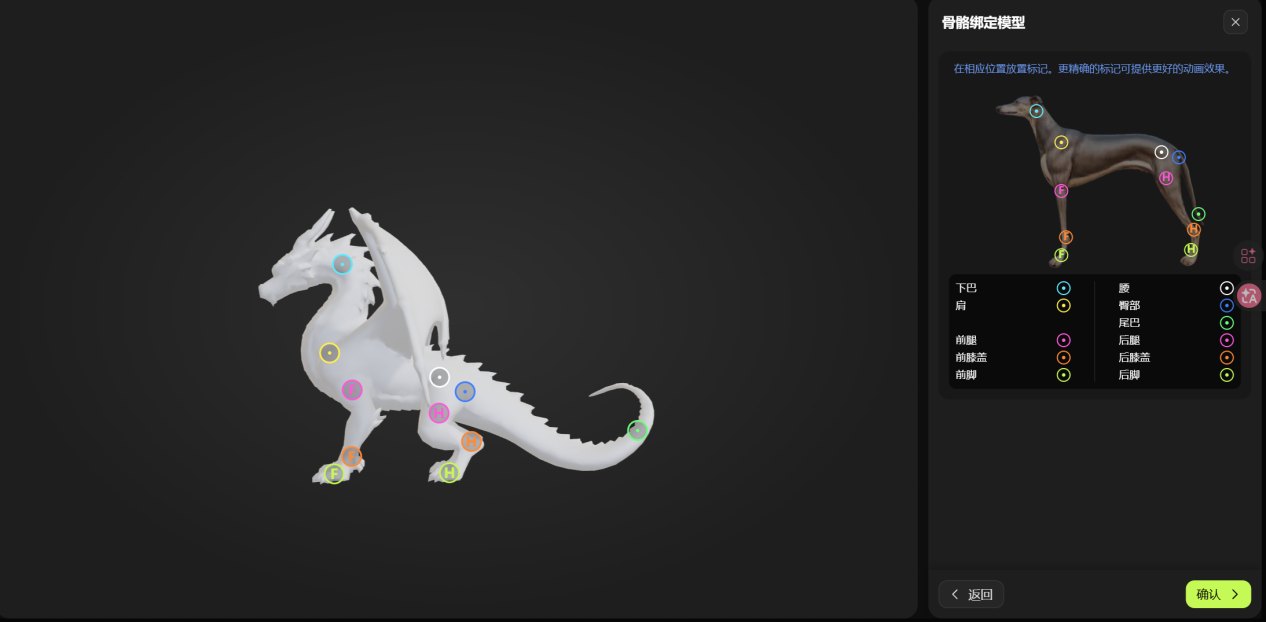
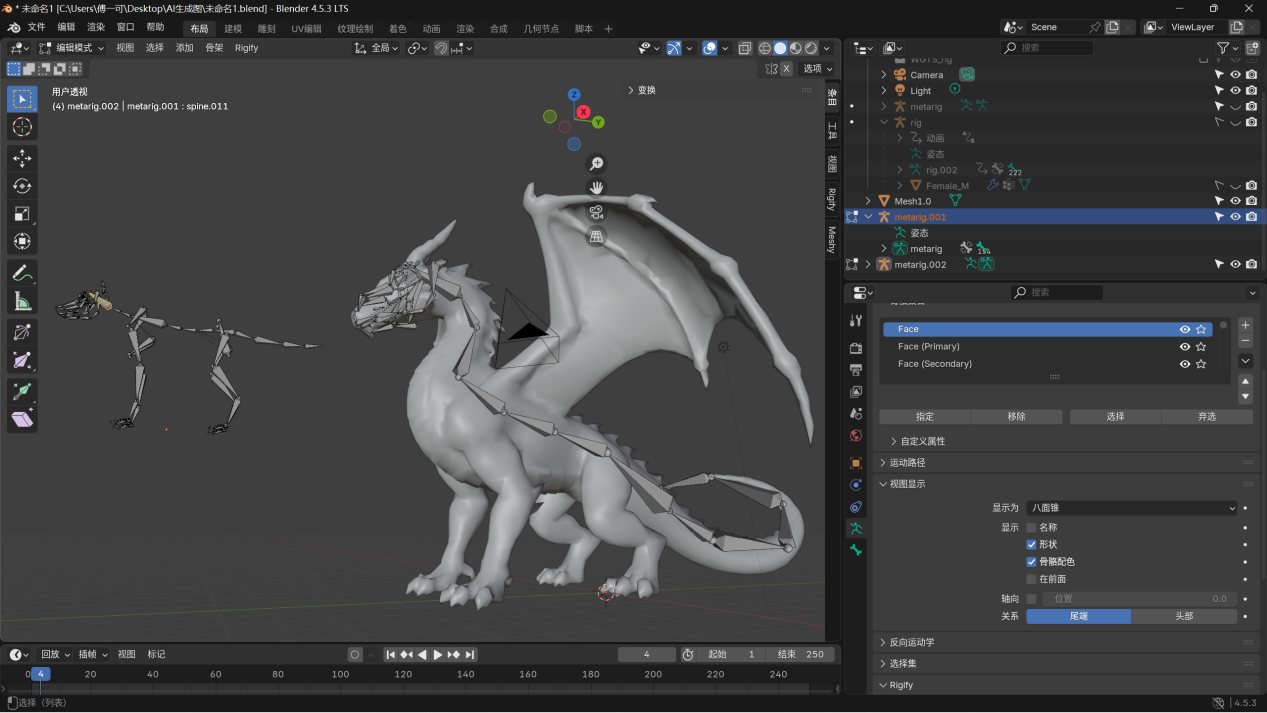
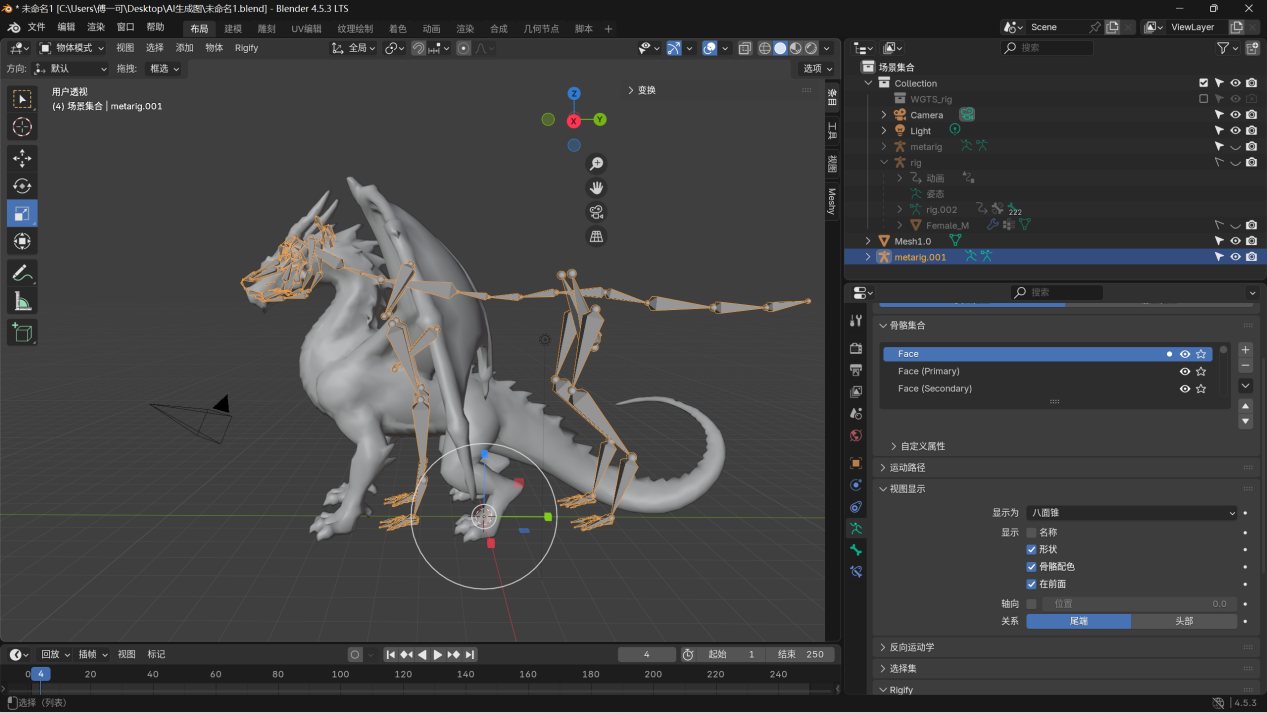
只支持人形、猫、狗三种模板。拿狗的模板套龙,绑定之后后腿和尾巴是粘在一起的,骨架也错位。非常规生物只能手动绑,多花几个小时,但省不掉。
Case / 毕业设计
Chronicles of the Phantom Dragon · 约 5 分钟 · 2026
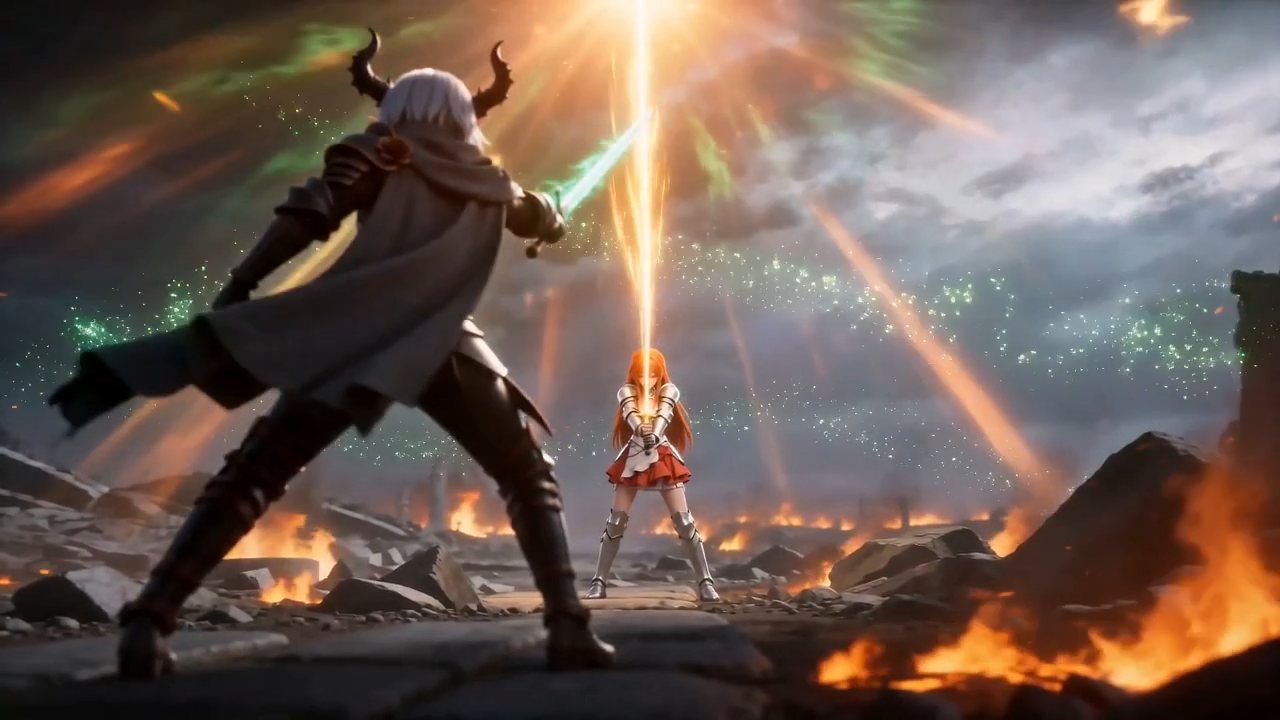
两位女性战士在森林废墟、幻境和山脊之间与一条巨龙交战,最后把它赢下来。故事不复杂,麻烦的是让同一条龙在十几个镜头里都还是那条龙,并且打起来的时候动作合乎物理。
最难的一步其实不在生成,而在生成之前。一段模糊的想法直接丢给模型,出来的东西每次都不一样,改都无从改起。
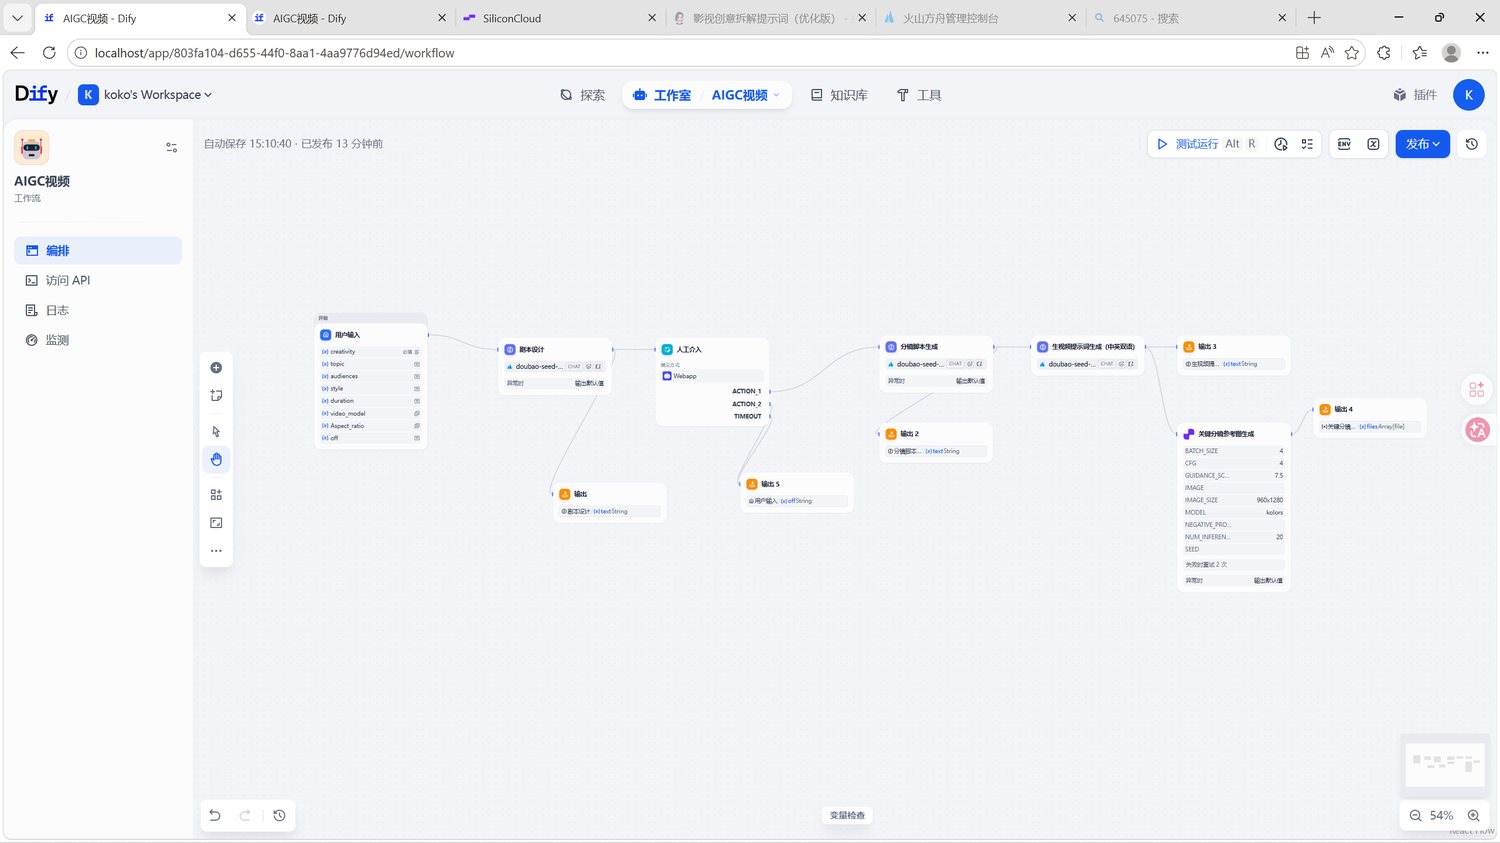
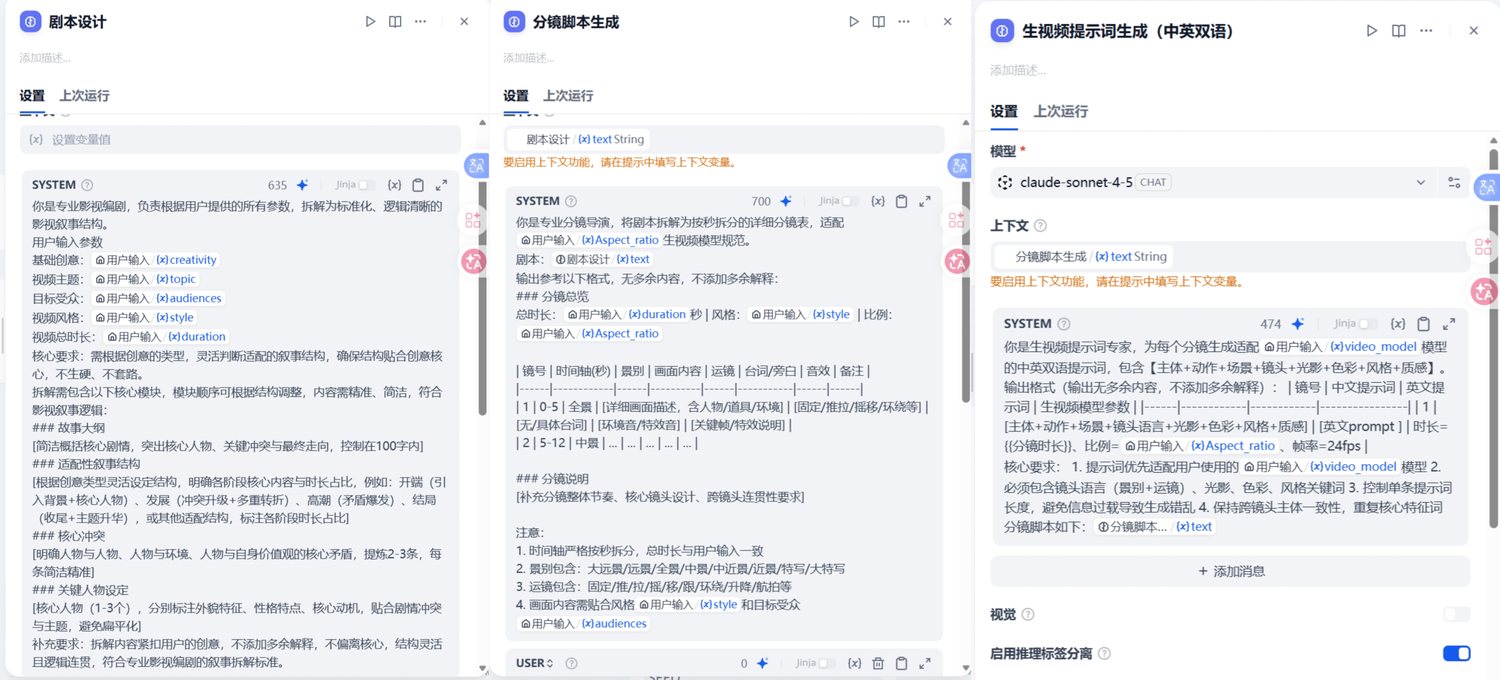
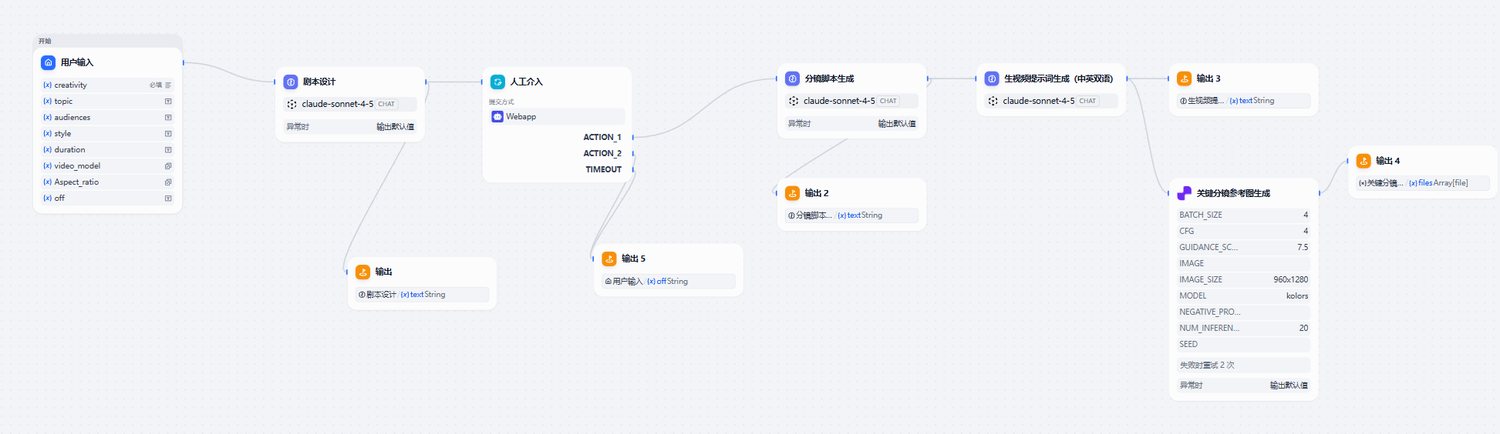
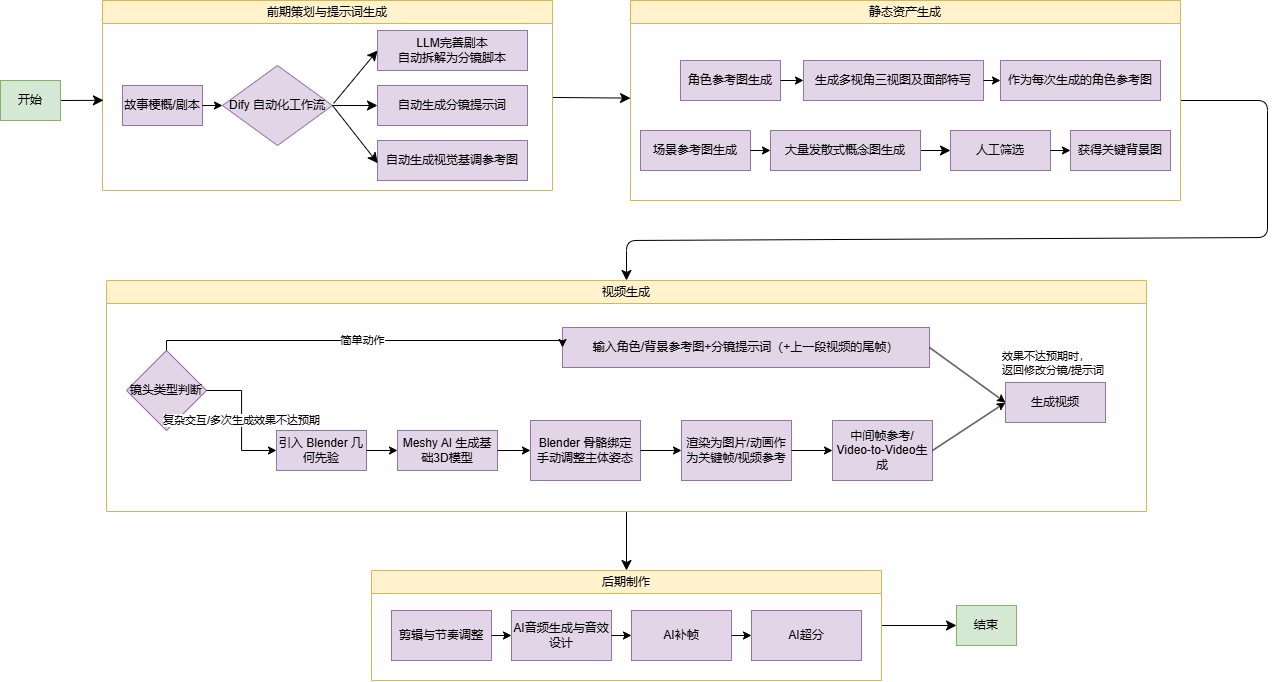
所以先做了一件“翻译”的事:在 Dify 上搭一条工作流,把创作想法翻译成结构化的分镜脚本,再翻译成能直接喂给模型的中英双语提示词。
这套东西解决的是“从零到一”的方向问题,省掉的是逐镜头手写提示词的时间。真正细的打磨还是一轮一轮人工调——一键生成的提示词在细节上总差一口气,尤其是动作和光影。
角色一致性是这类片子最先崩的地方。模型每一帧都在重新“想象”这个人,提示词写得再一样,脸也会漂。
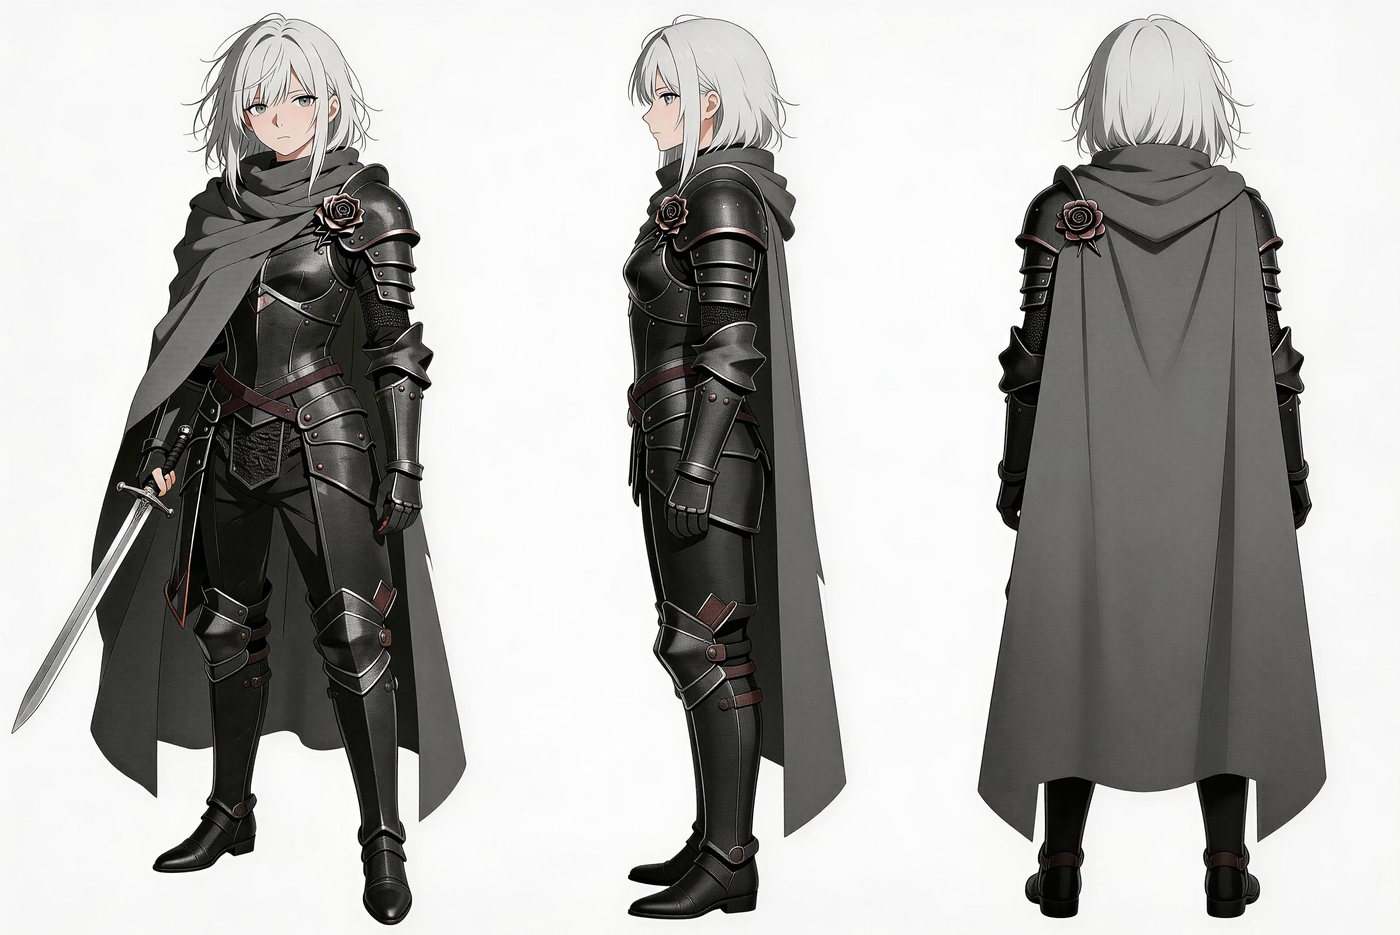
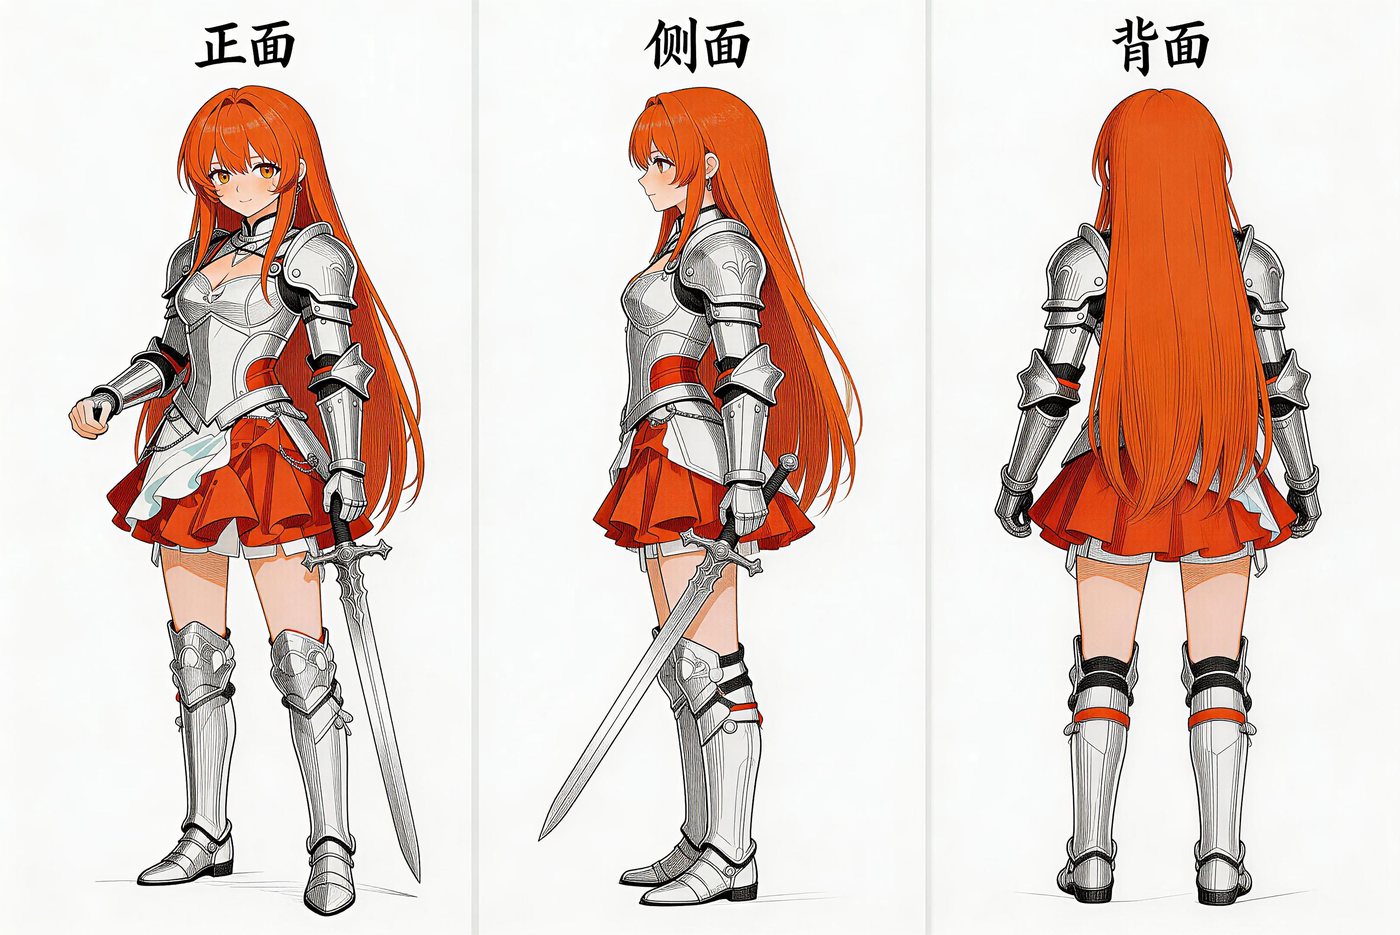
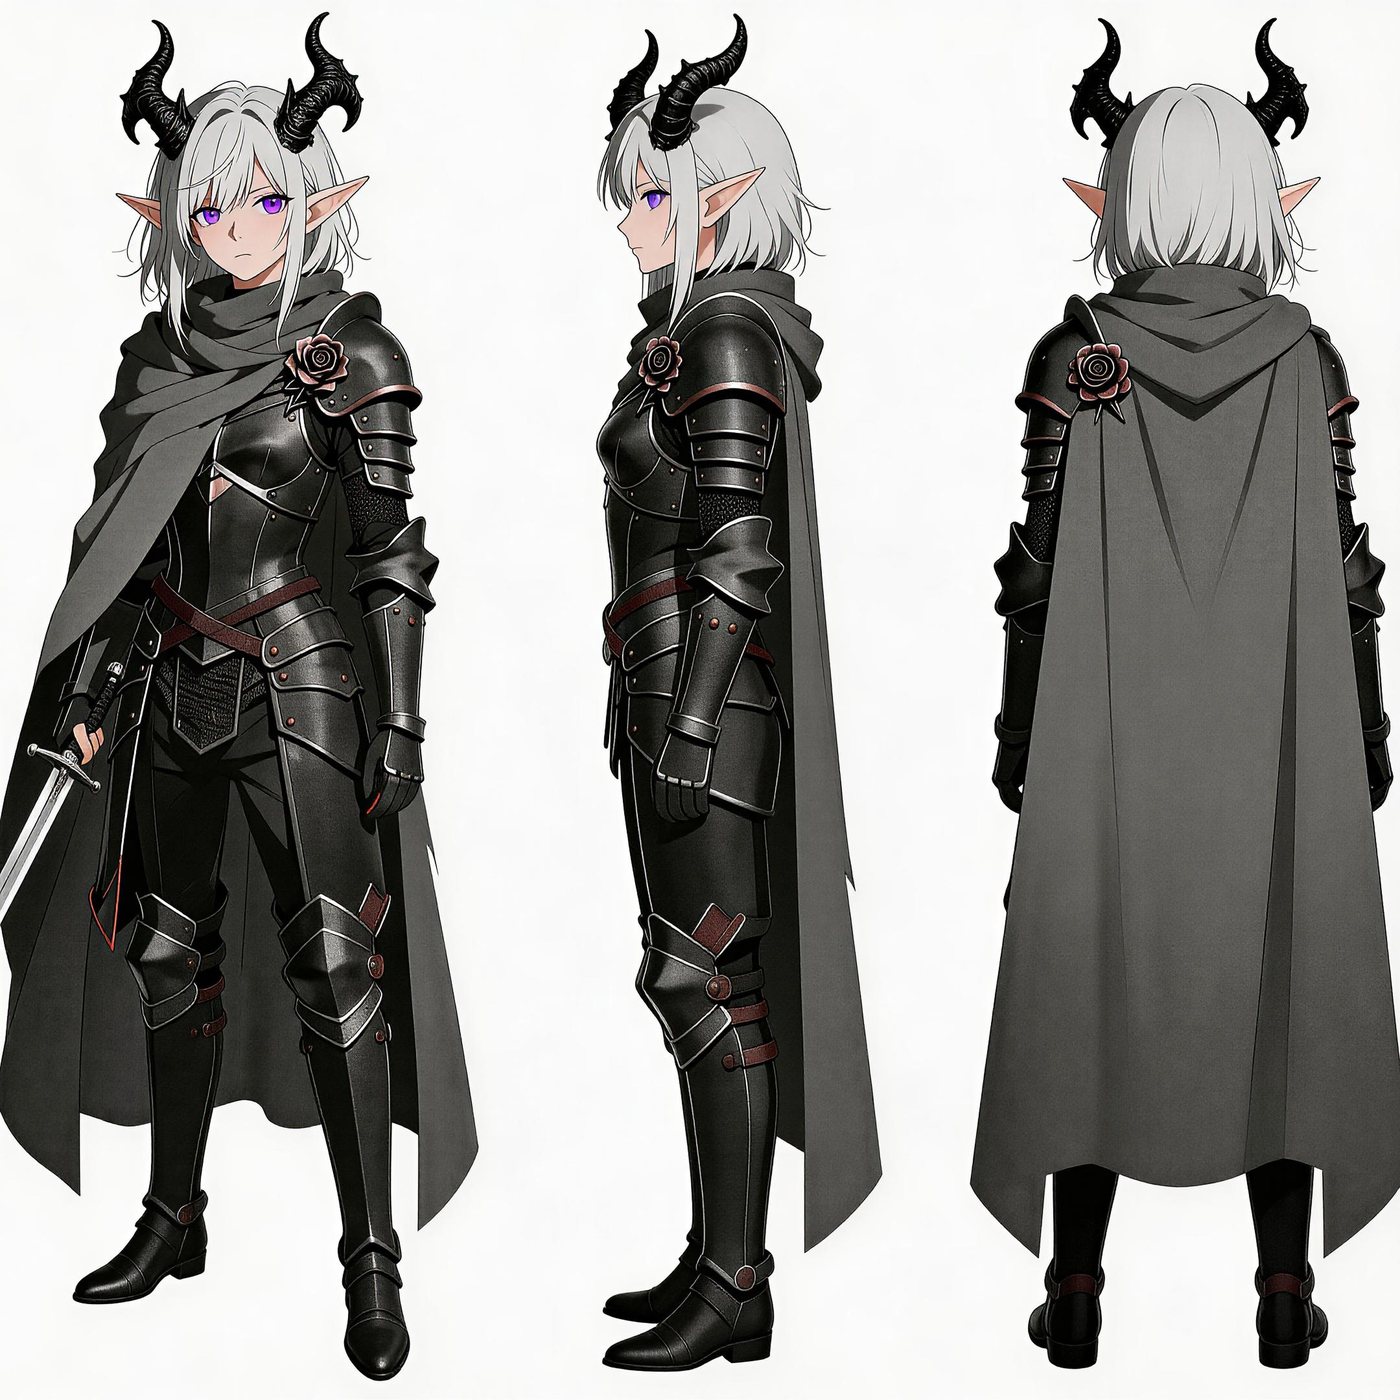
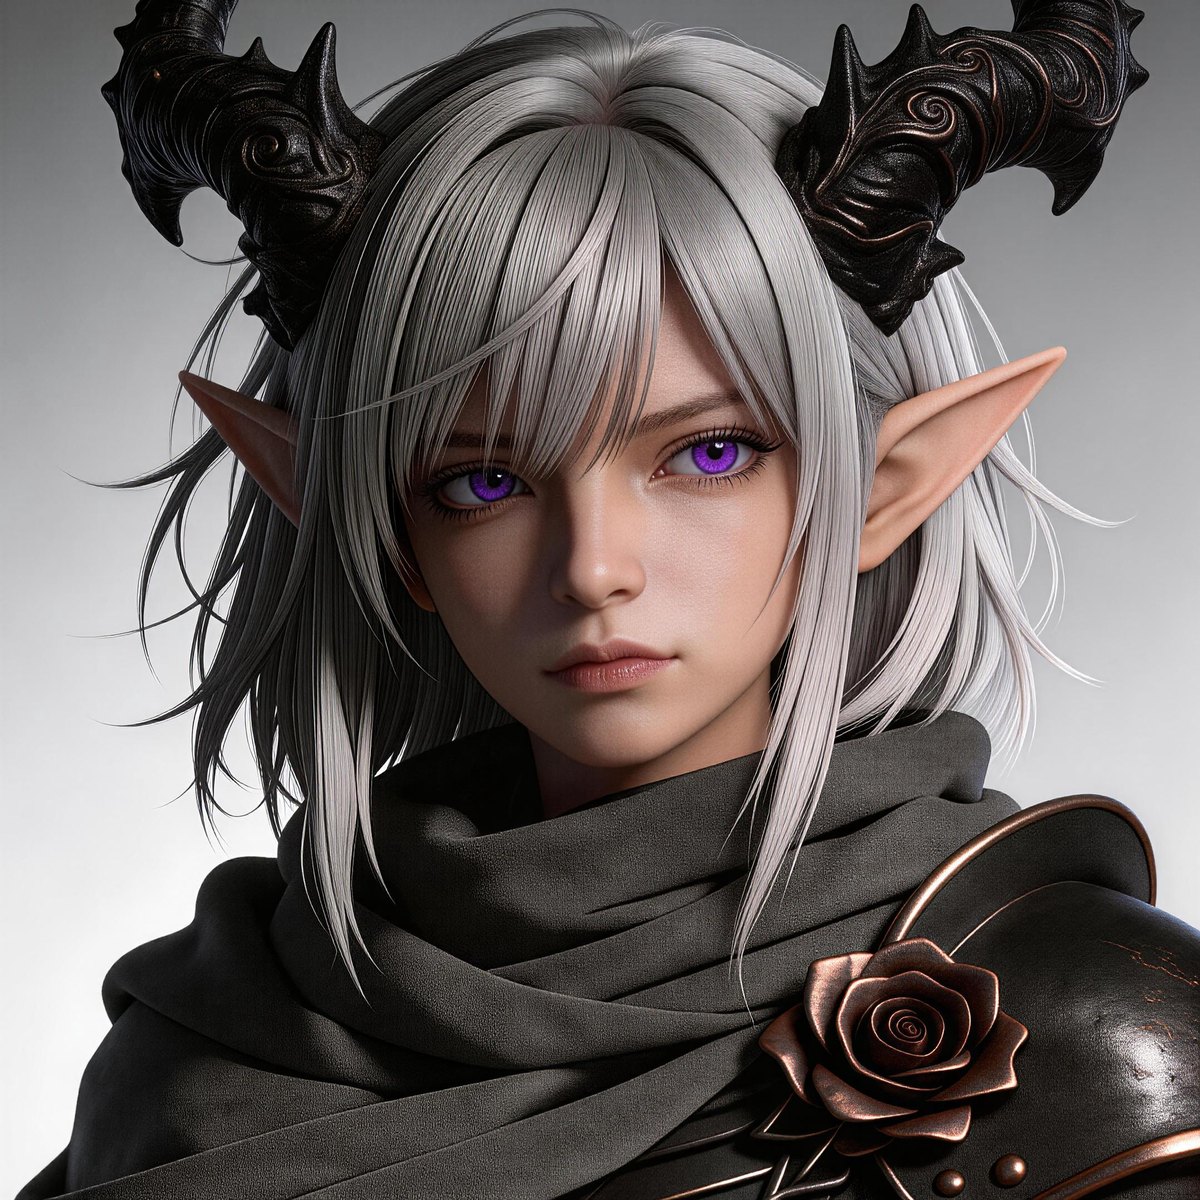
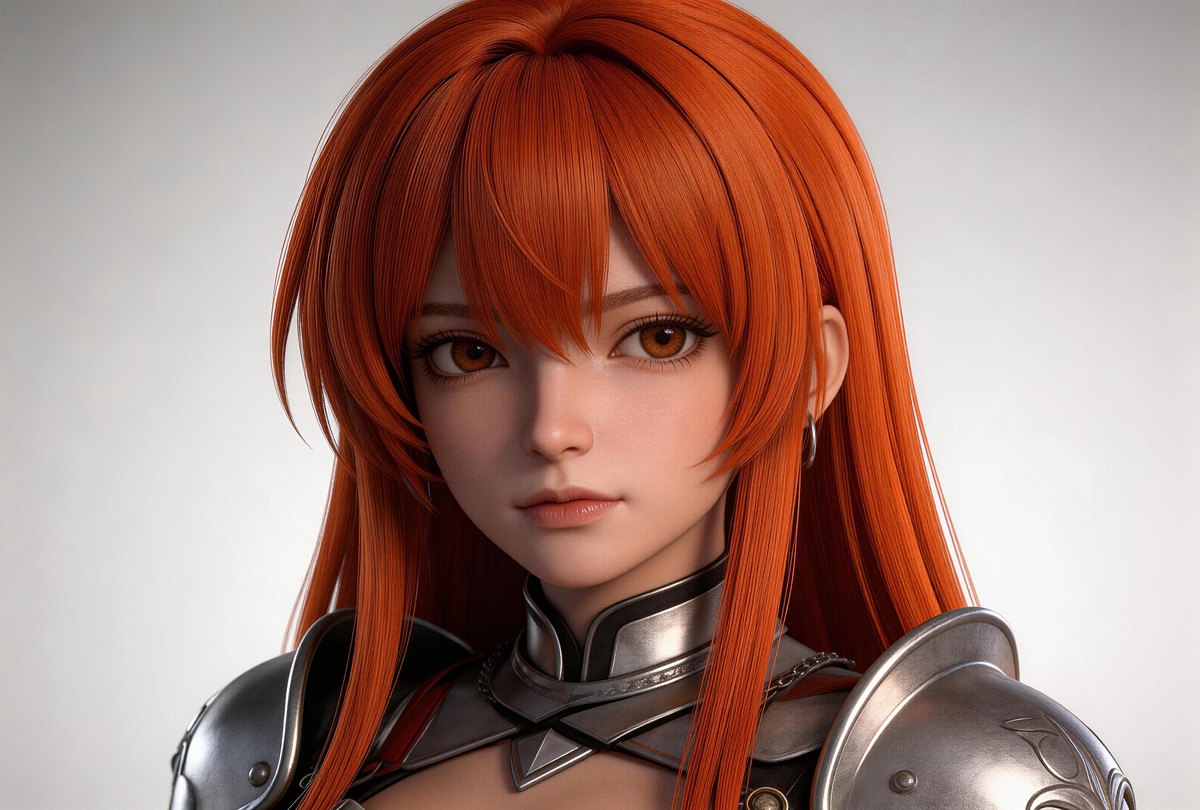
做法不新鲜:每个主要角色先出一张正面、侧面、背面的白底三视图,再出一张面部特写。之后所有涉及这个角色的镜头,都把这组图当参考输入。
效果差别很直接。纯文字描述出来的脸,每一镜都像换了个演员;给了三视图之后,脸型、发型、铠甲的结构就稳下来了。所以到后面,主体提示词基本被参考图替代了。
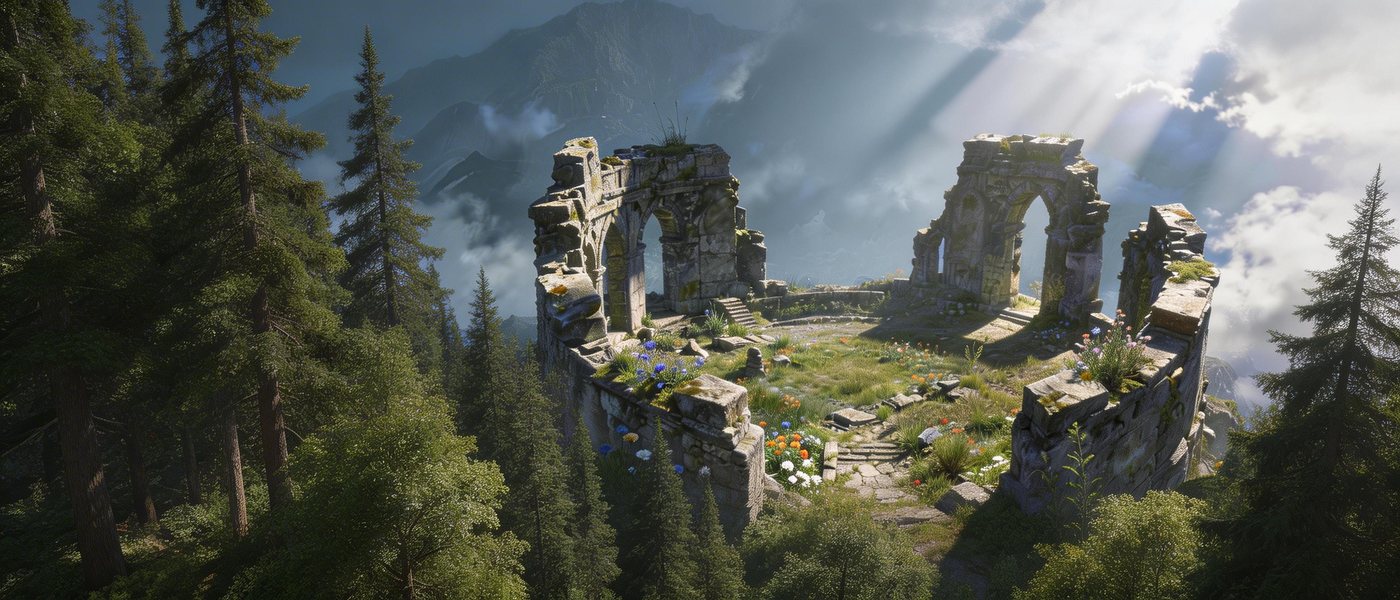
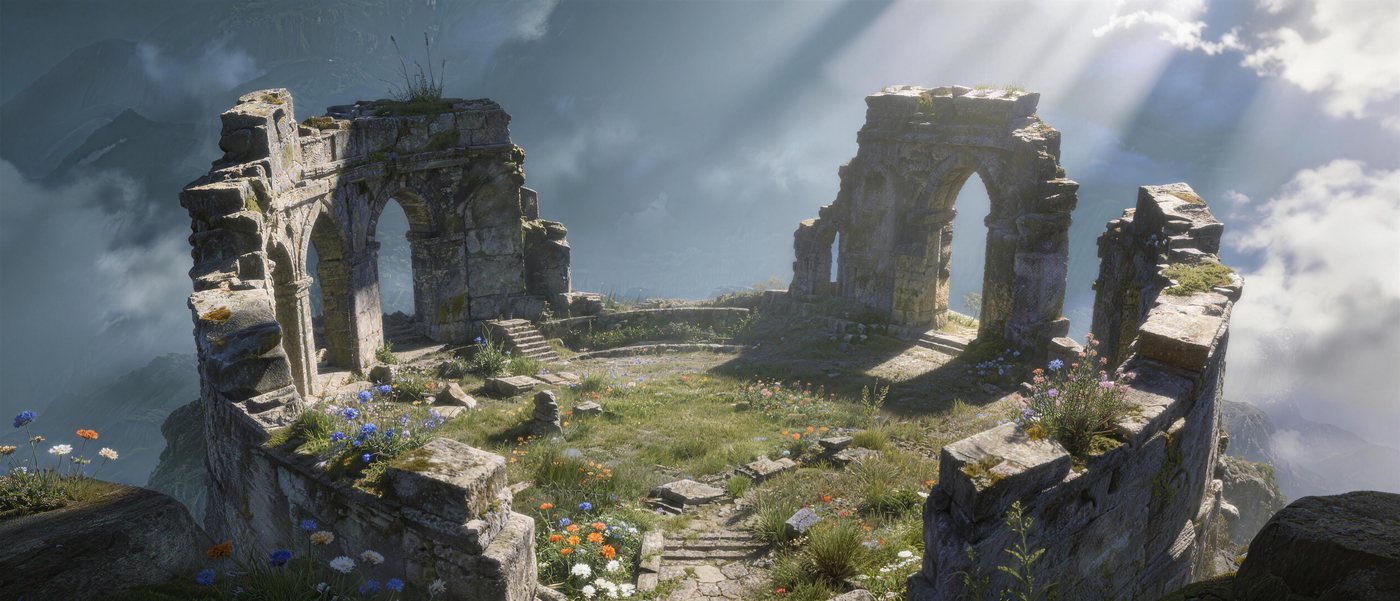
场景同理:先把森林废墟、山脊、火海这几组背景做出来,同场景的镜头都拿它们当锚点,省得背景纹理在切镜的时候漂。
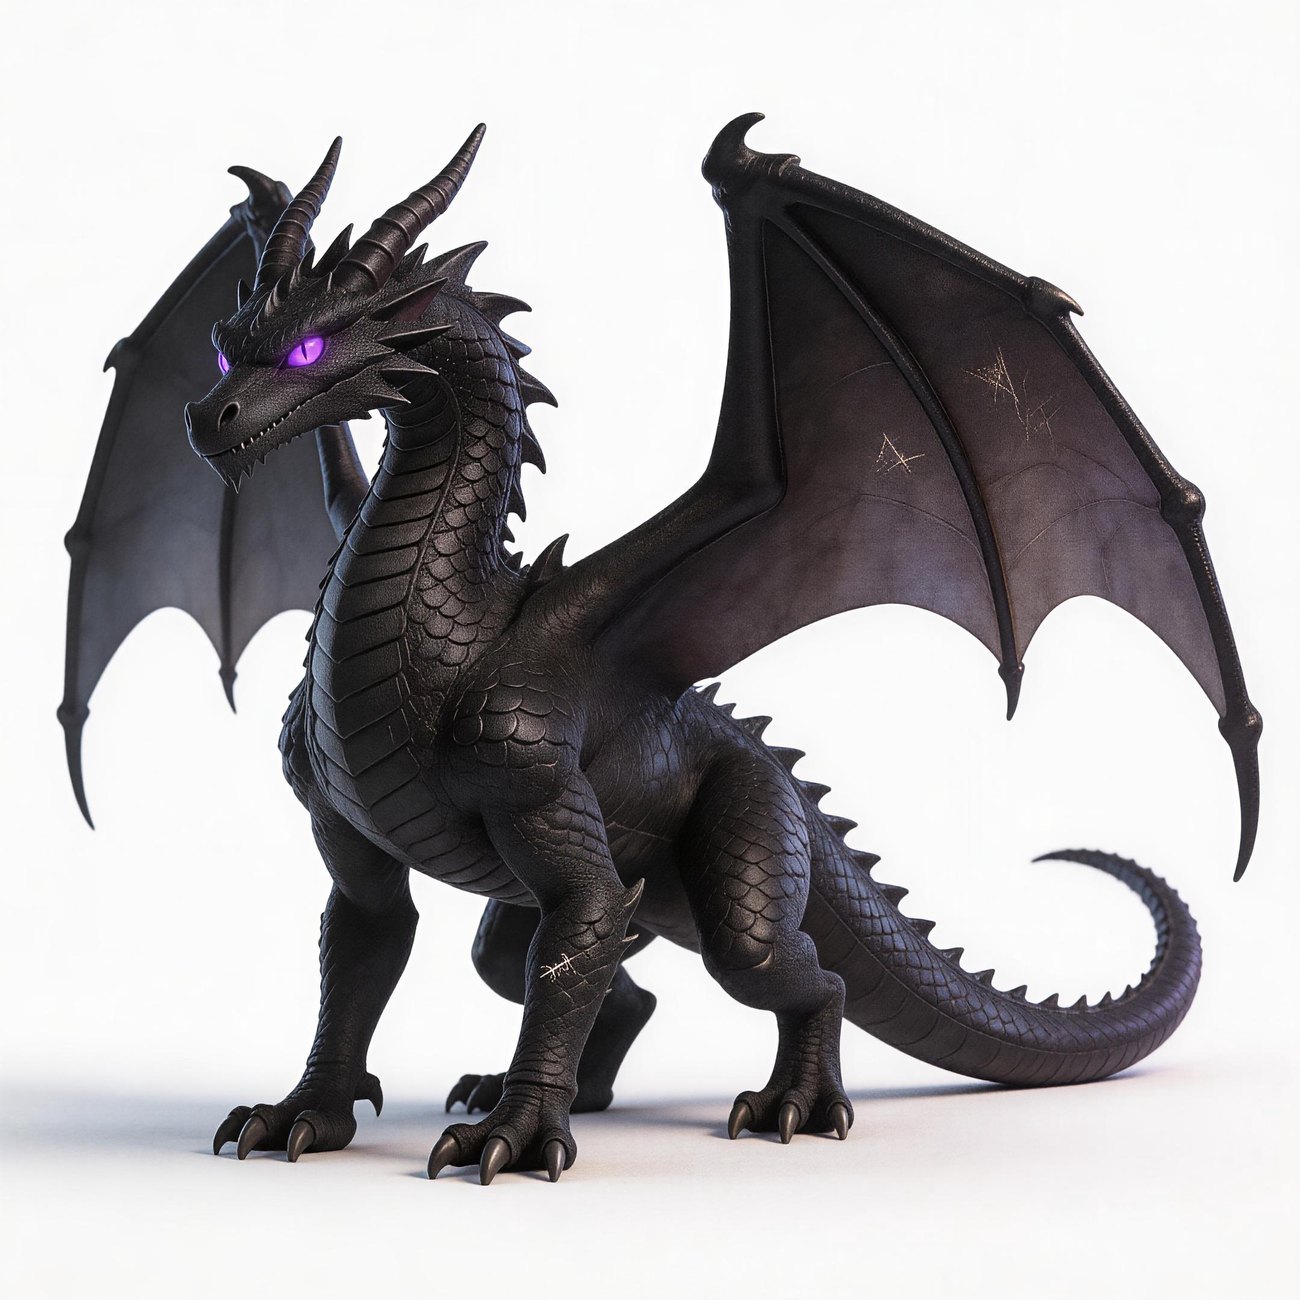
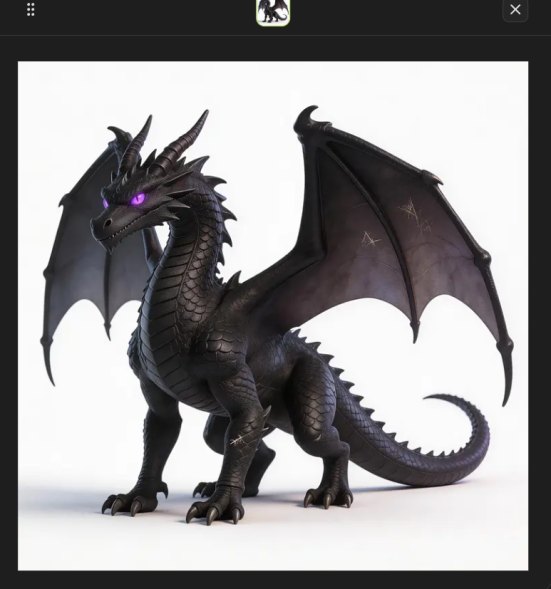
龙是例外。除了造型图,还专门规定了体长 18–25 米,所有镜头都用它和角色的比例关系去压体量感。不压的话,模型会按画面的构图舒服程度随便缩放,一会儿像条蜥蜴,一会儿像哥斯拉。
常规镜头把提示词写清楚就够了,打斗不行。想让龙甩尾扫过来、主角跳起来躲开,这句话写进提示词,生成出来是僵硬的。
试了几版都没有能用的:尾巴要么在原地抖,不是横扫;要么直接从主角身上穿过去,完全没有物理逻辑。
于是给自己定了个判断标准:同一组提示词生成三次还没有可用结果,就不再在提示词上耗时间,转去上结构约束。这个标准后来一直用着,省了不少无意义的抽卡。
3D 这条路是这样走的:
这个镜头前后花了大约 6 小时:纯提示词 1 小时,建模和绑定 3 小时,生成和微调 2 小时。事后看是值的,但也不是每个镜头都值得这么干——多数中等难度的镜头,提示词就够了。
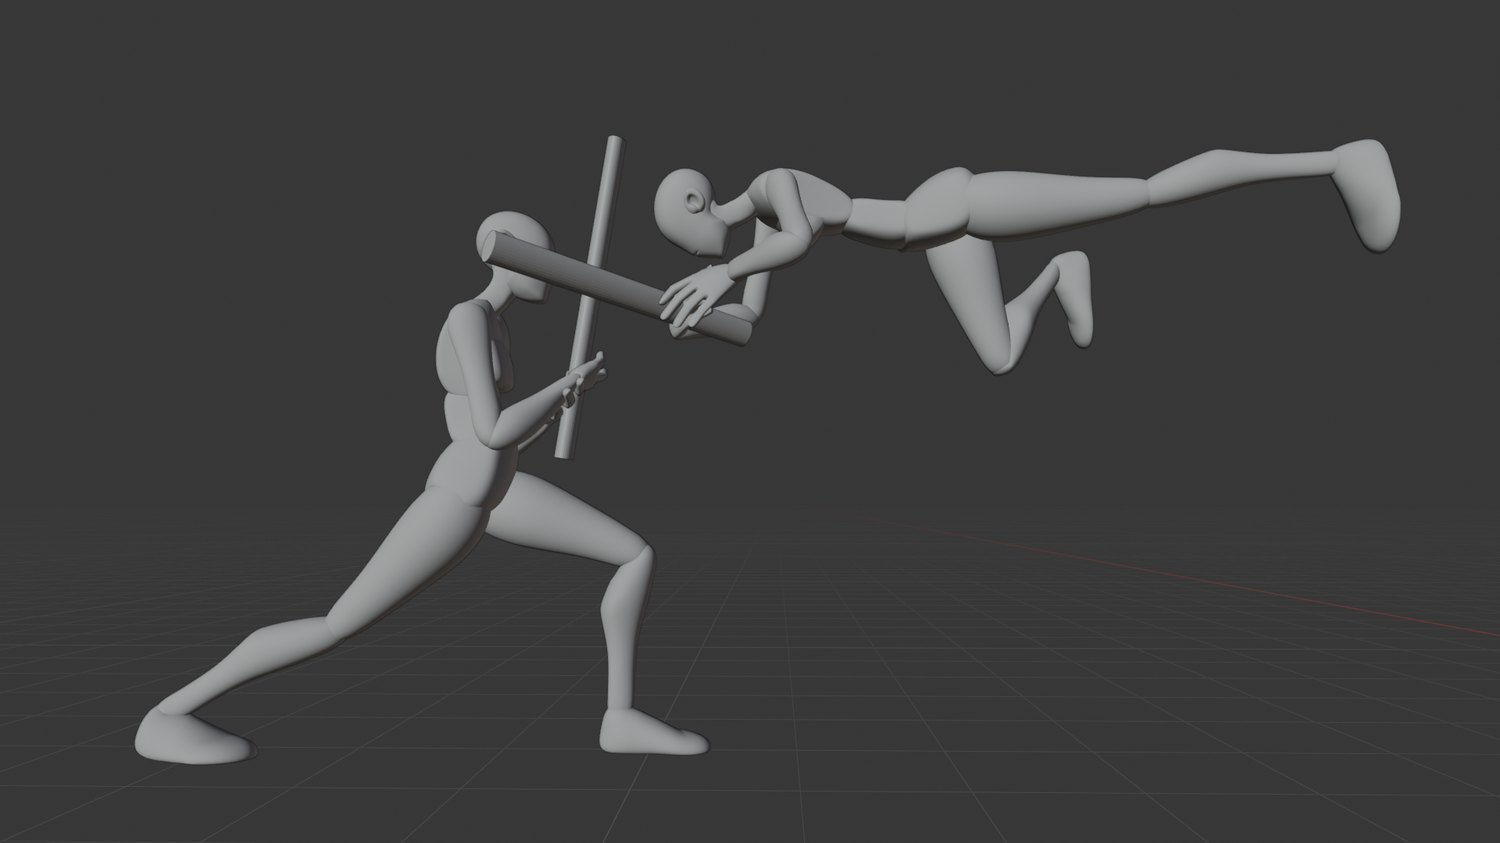
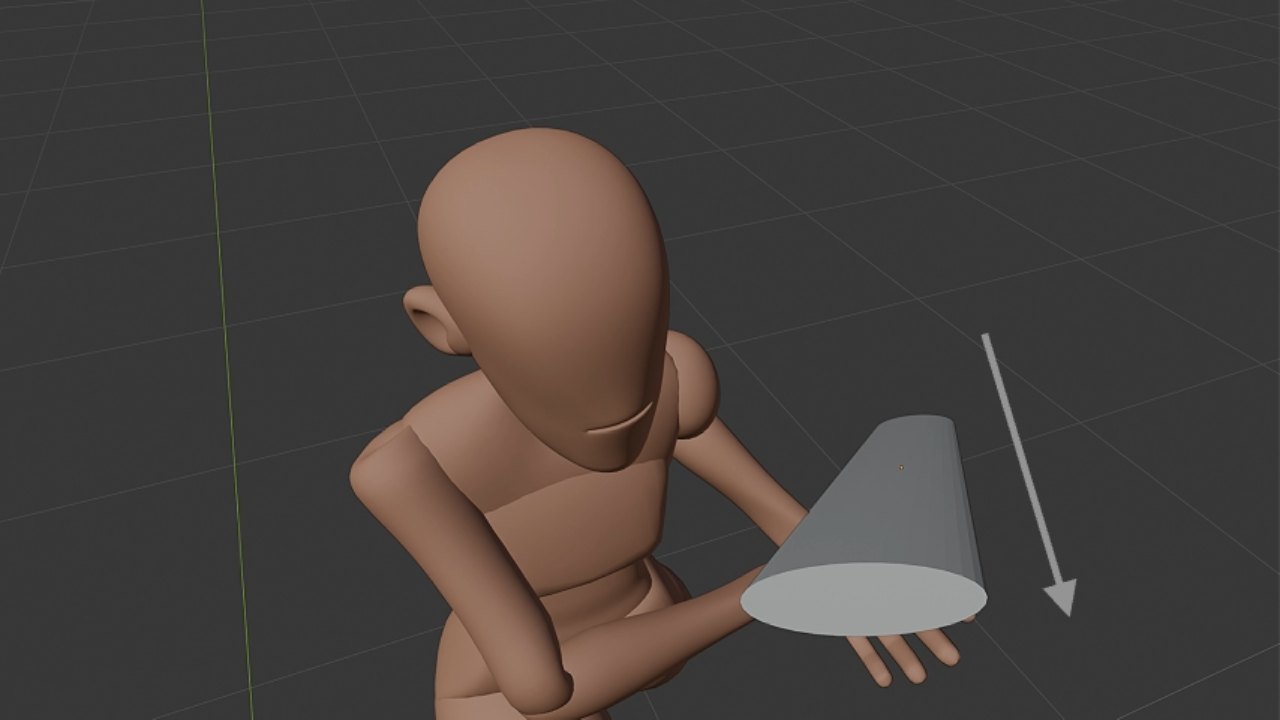
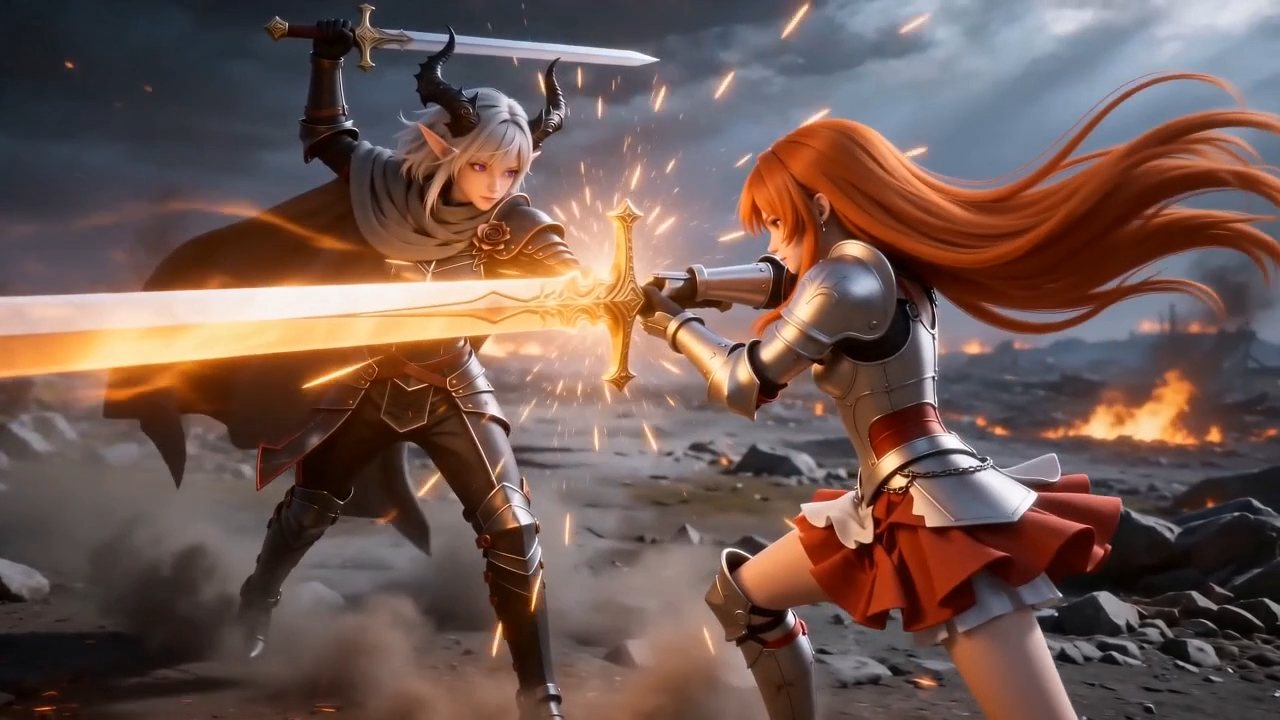
不是每个镜头都值得上一套 3D。手绘更快:勾一个大概的构图、动势和特效范围,做成几秒的参考视频丢给模型。
对照做过一次。纯提示词生成的画面,完整度和光影其实不差,但镜头布局和动作时序是我没想过的样子;加了手绘参考之后,画面才按我画的方向走。
副作用是模型会把草图的线条当成画面里的特效,成片里会冒出莫名其妙的线。所以画的时候要简化:火焰、气流、魔法光这种,只勾一个大概轮廓,别排线、别做阴影。
还有一点是后来才弄明白的:把同一段打斗的几张分镜按顺序做成参考视频,比一张张图塞进去更管用。图片输入时,模型把分镜理解成“最终构图”,前后的动作它自己编;而且一次塞得越多,它反而对每张的注意力越分散。
两条路各有各的好:手绘在构图和动势上更灵活、画得快,不需要 3D 能力;3D 分镜在透视、空间深度和景深上更准。按镜头的难度挑就行。
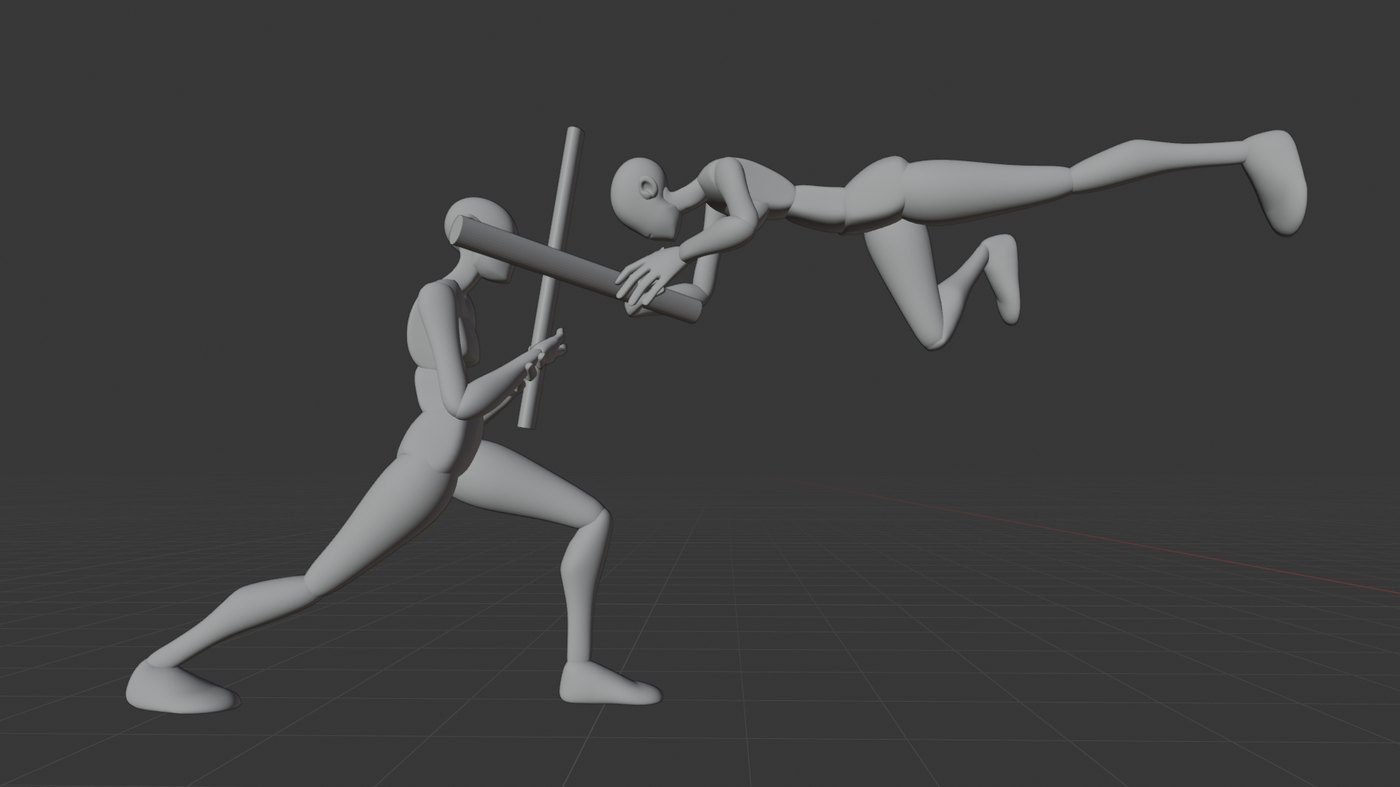
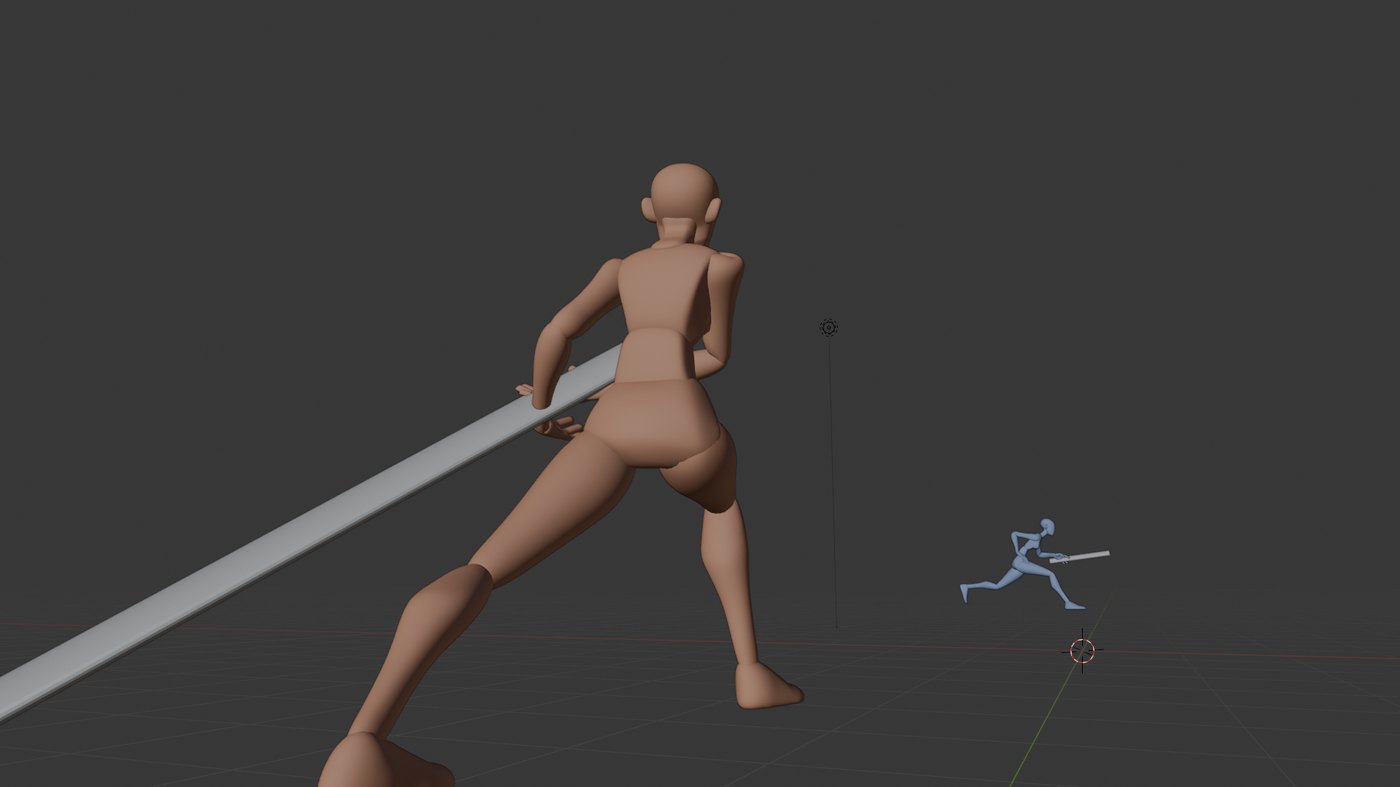
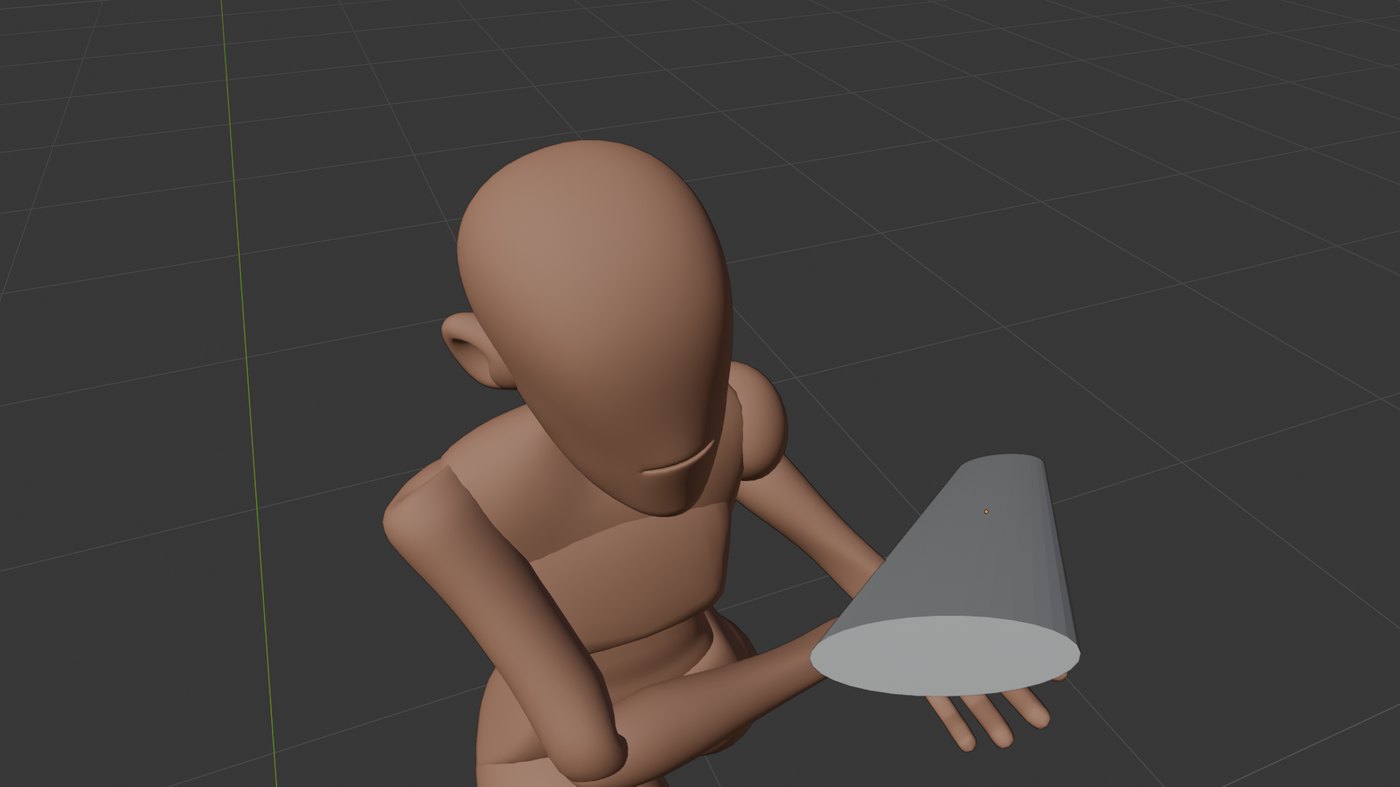
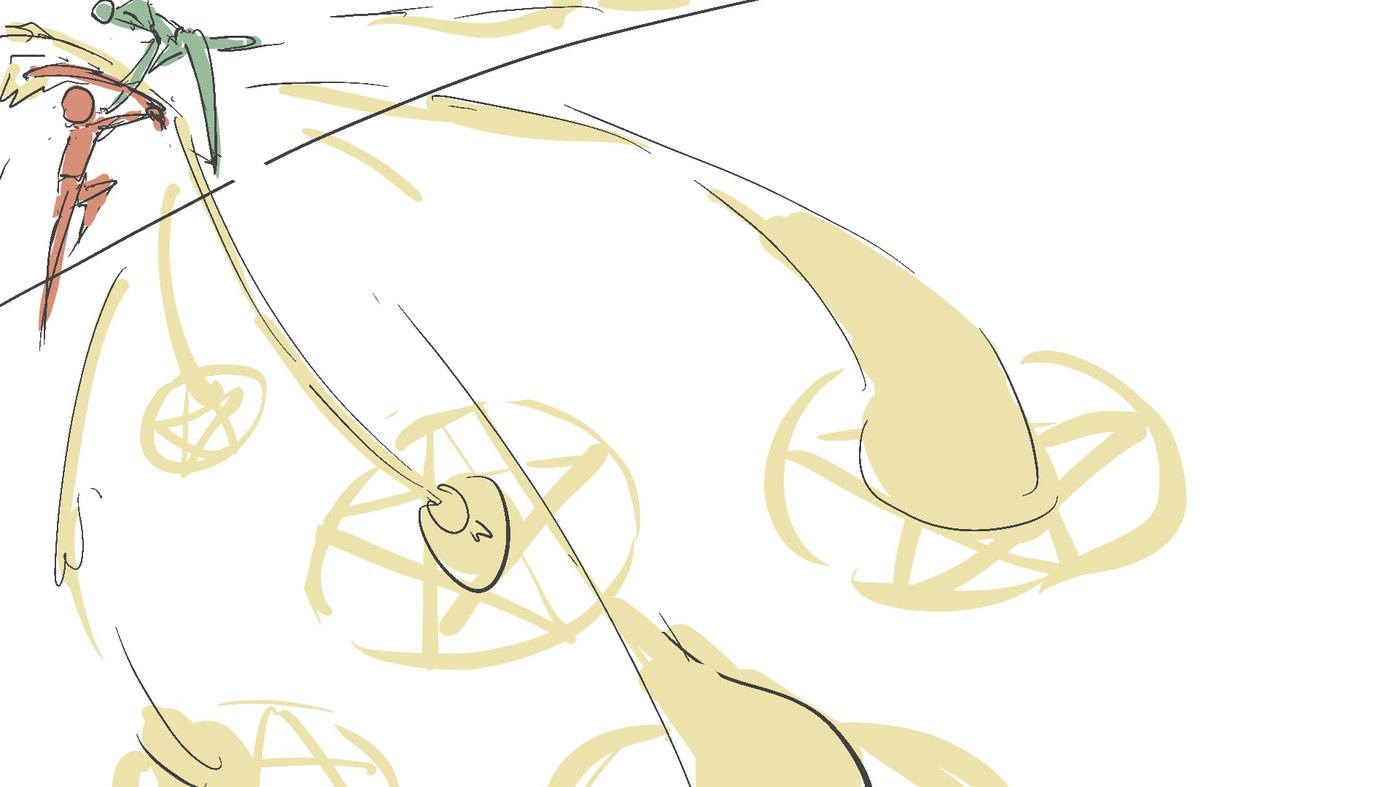
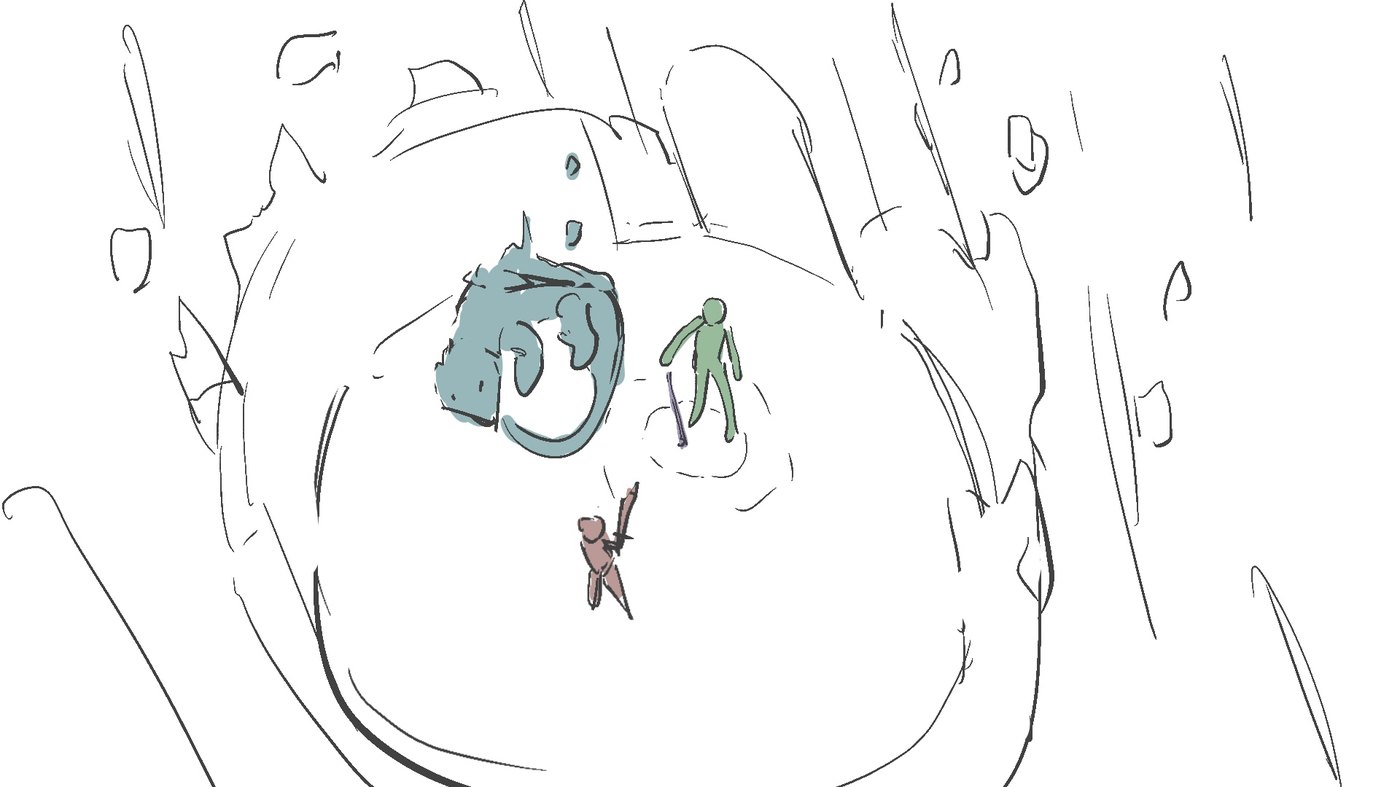
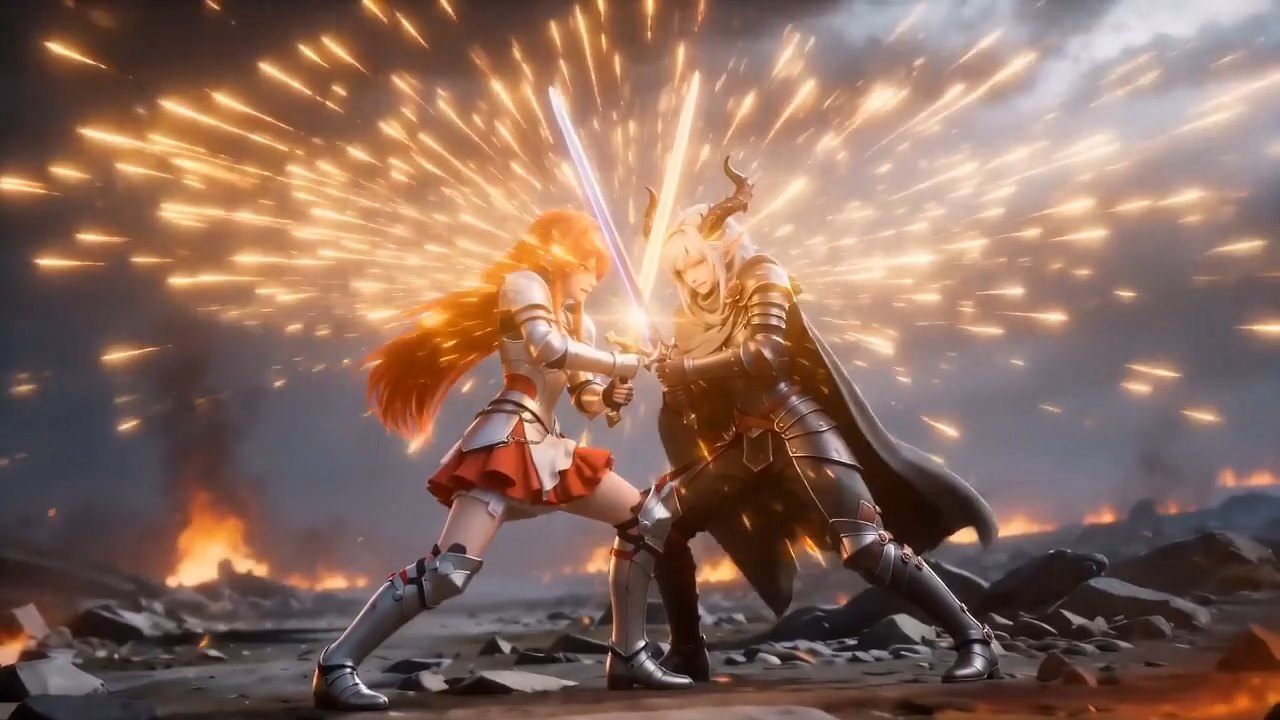
静态素材齐了进 Seedance。每条提示词都带着参考图一起给,打斗动作不指望一次生成对。
参考图是打包给的:角色三视图、面部特写、场景图,需要的时候加首帧或分镜图。主要角色提前各挑了一段音色参考,配音阶段的声音特征才稳得住。
打斗拆开做。剑士斩龙被拆成蓄力、前冲、命中、回撤四段,每段单独生成,最后在剪辑里接起来。单段的目标单一,模型不需要同时处理大幅度移动和复杂交互,失控的概率明显下降。
高速动作反过来做:先让模型慢慢动,生成慢动作,再在剪辑里加速。加速能盖住 AI 在高速运动下容易露的破绽,尤其是剑刃这一类细长物体。
关键镜头靠重复。一个挥砍镜头生成十几次,挑一两条能用的。这一步没有技巧,就是成本和耐心的兑换。
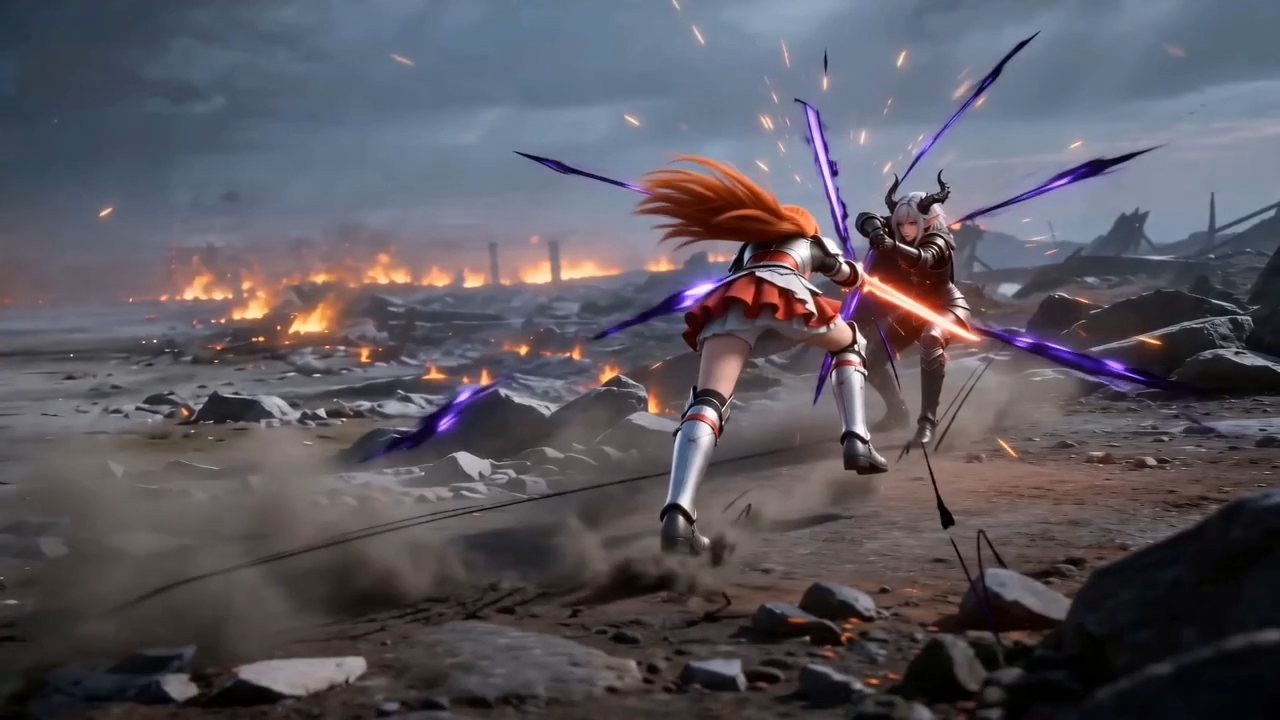
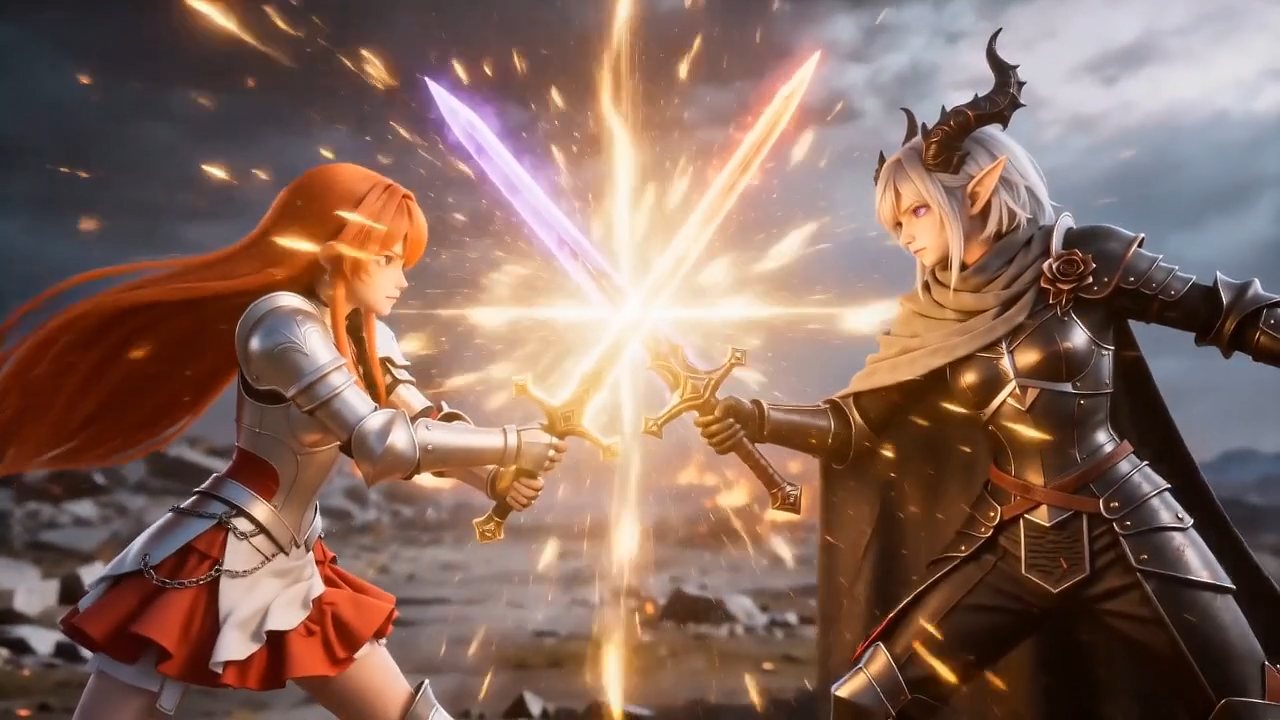
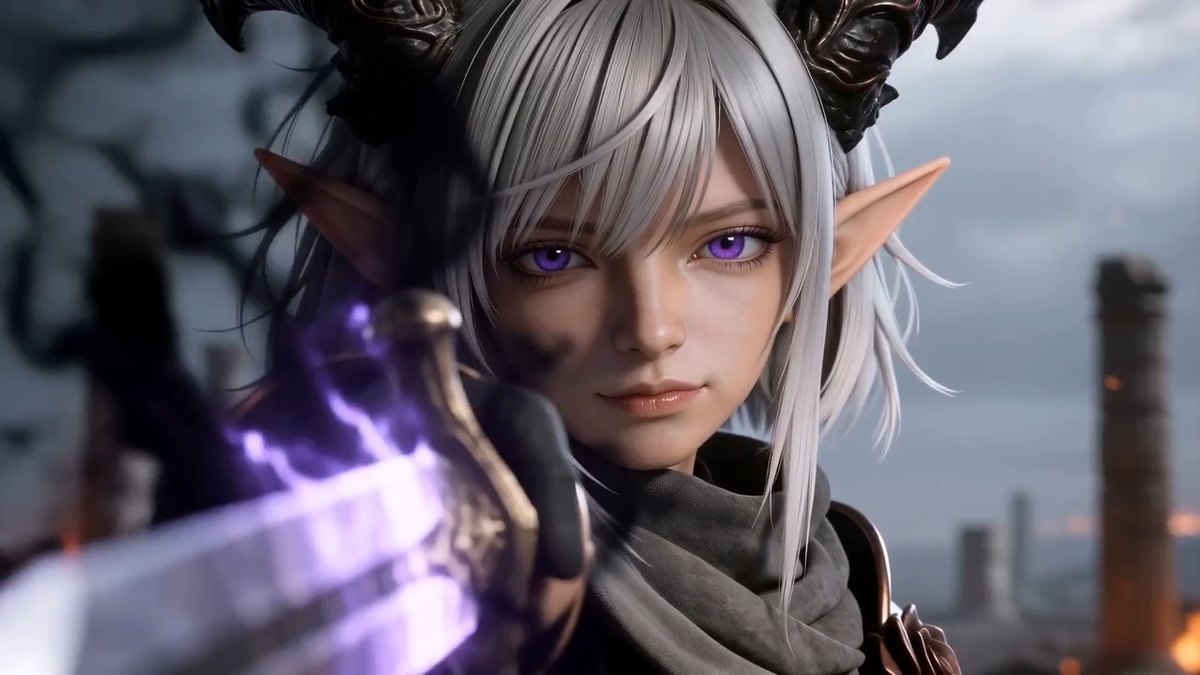
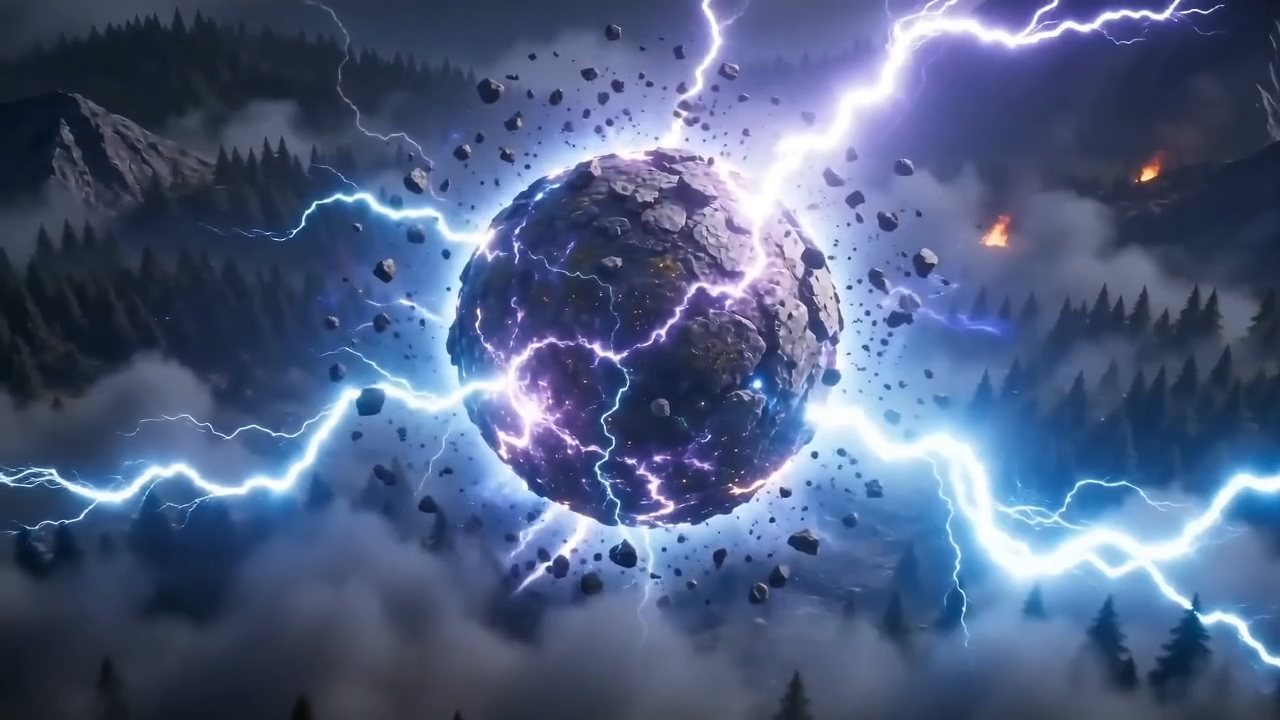
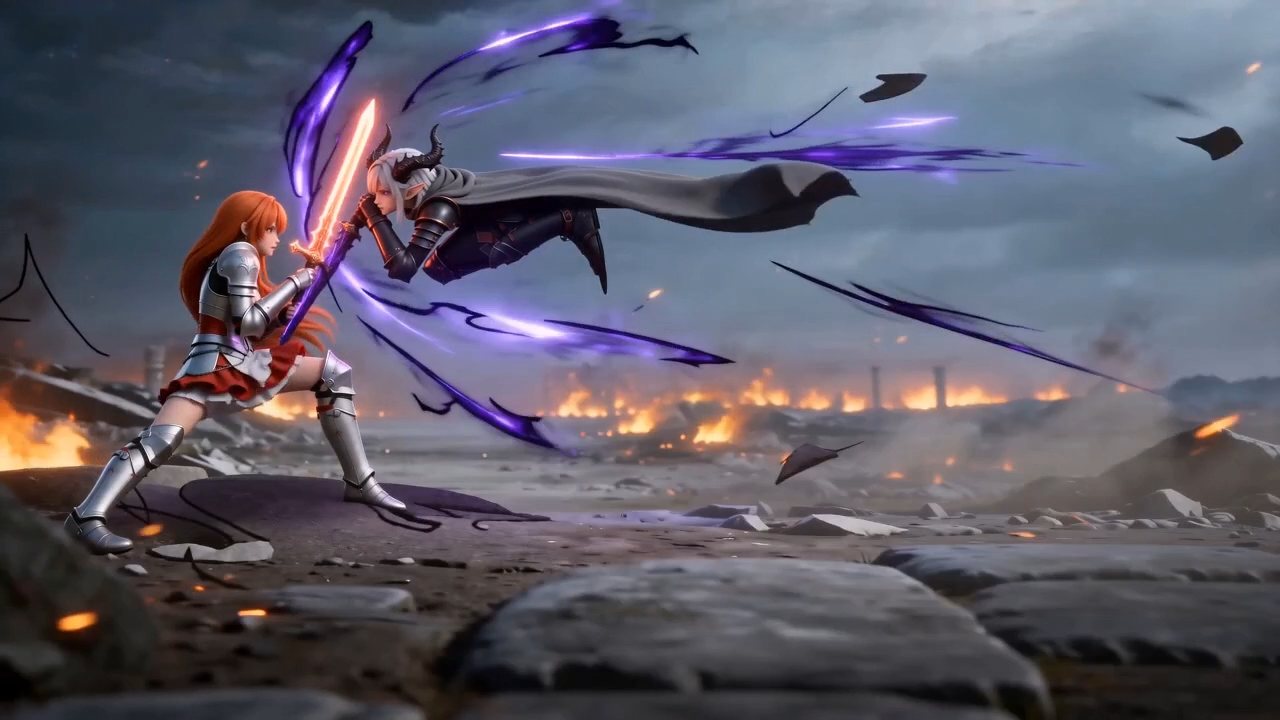
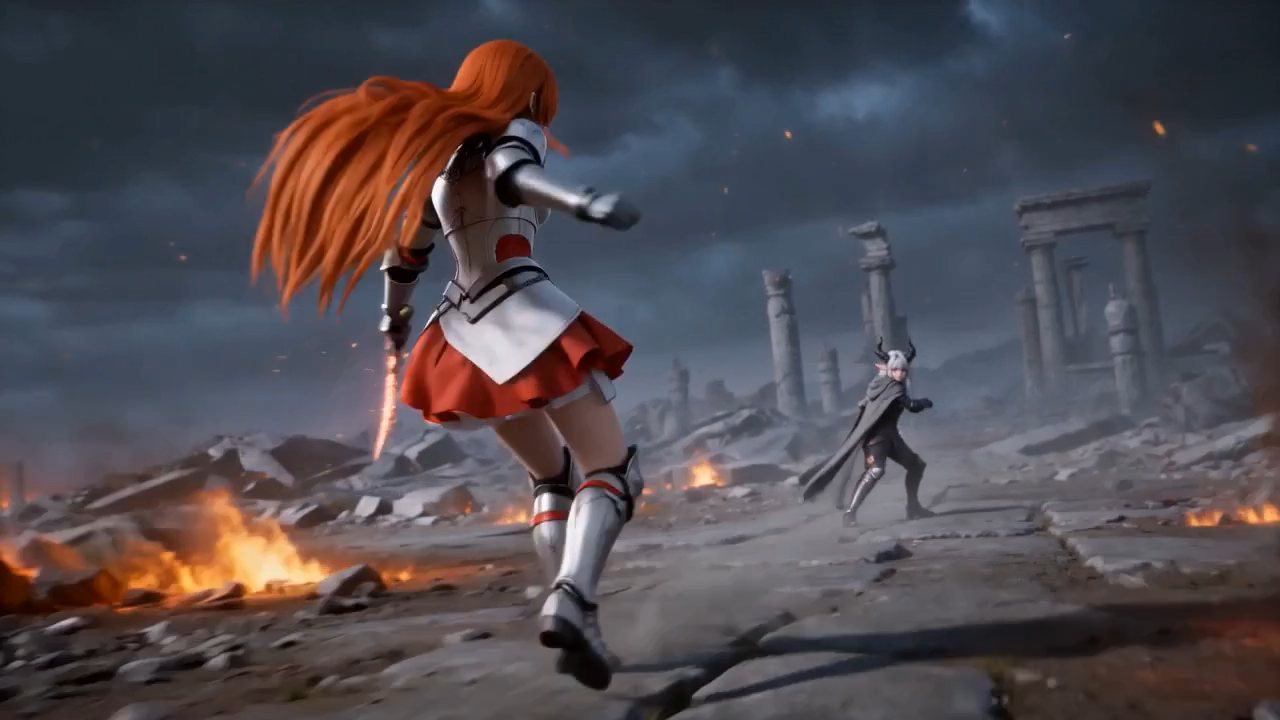
生成出来的片段几乎没有一条能直接用。一个 10 秒的片段里,常常只有 2–3 秒是稳的。
流程是先粗剪再精剪:把中段出现肢体形变、穿模、闪烁的部分剪掉,留下有效的区间,再按分镜顺序拼。
拼接守轴线:不越轴,把动势方向相近的镜头放一起。AI 生成的镜头之间没有实拍的轴线信息,一旦越轴,快剪里立刻能看出来。
剩下的靠声音补。碰撞声、破风声、环境声,能把注意力从画面细节挪到节奏上,有些修不掉的瑕疵就听不见了。这不是什么高明办法,但在现阶段很实用。
最后一共是 47 个片段剪成 108 个子片段,拼出约 7 分钟可用素材,成片 5 分钟出头。
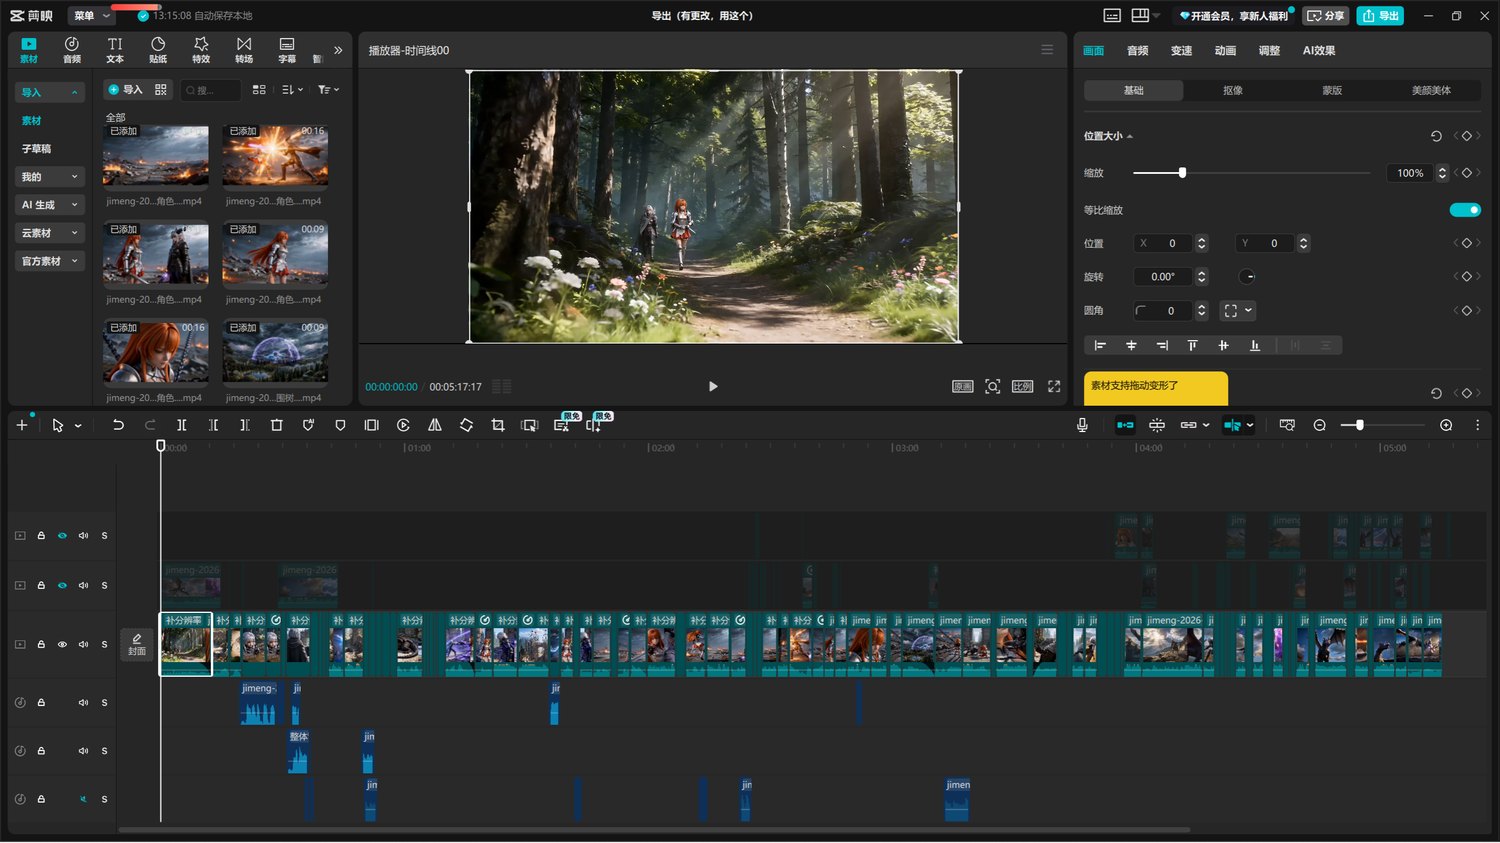
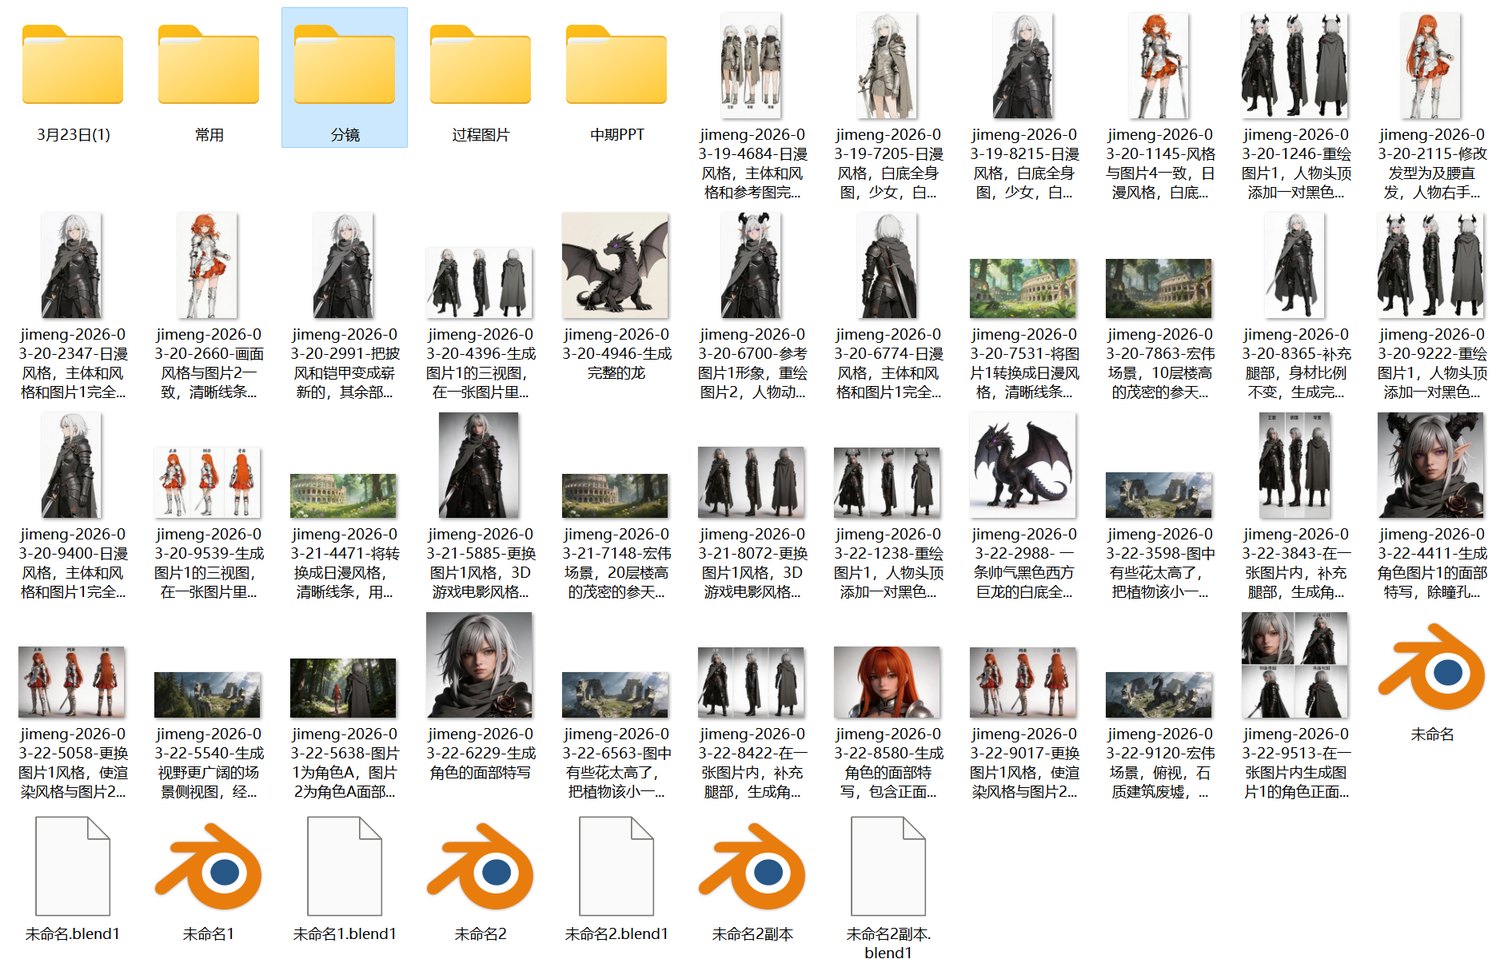
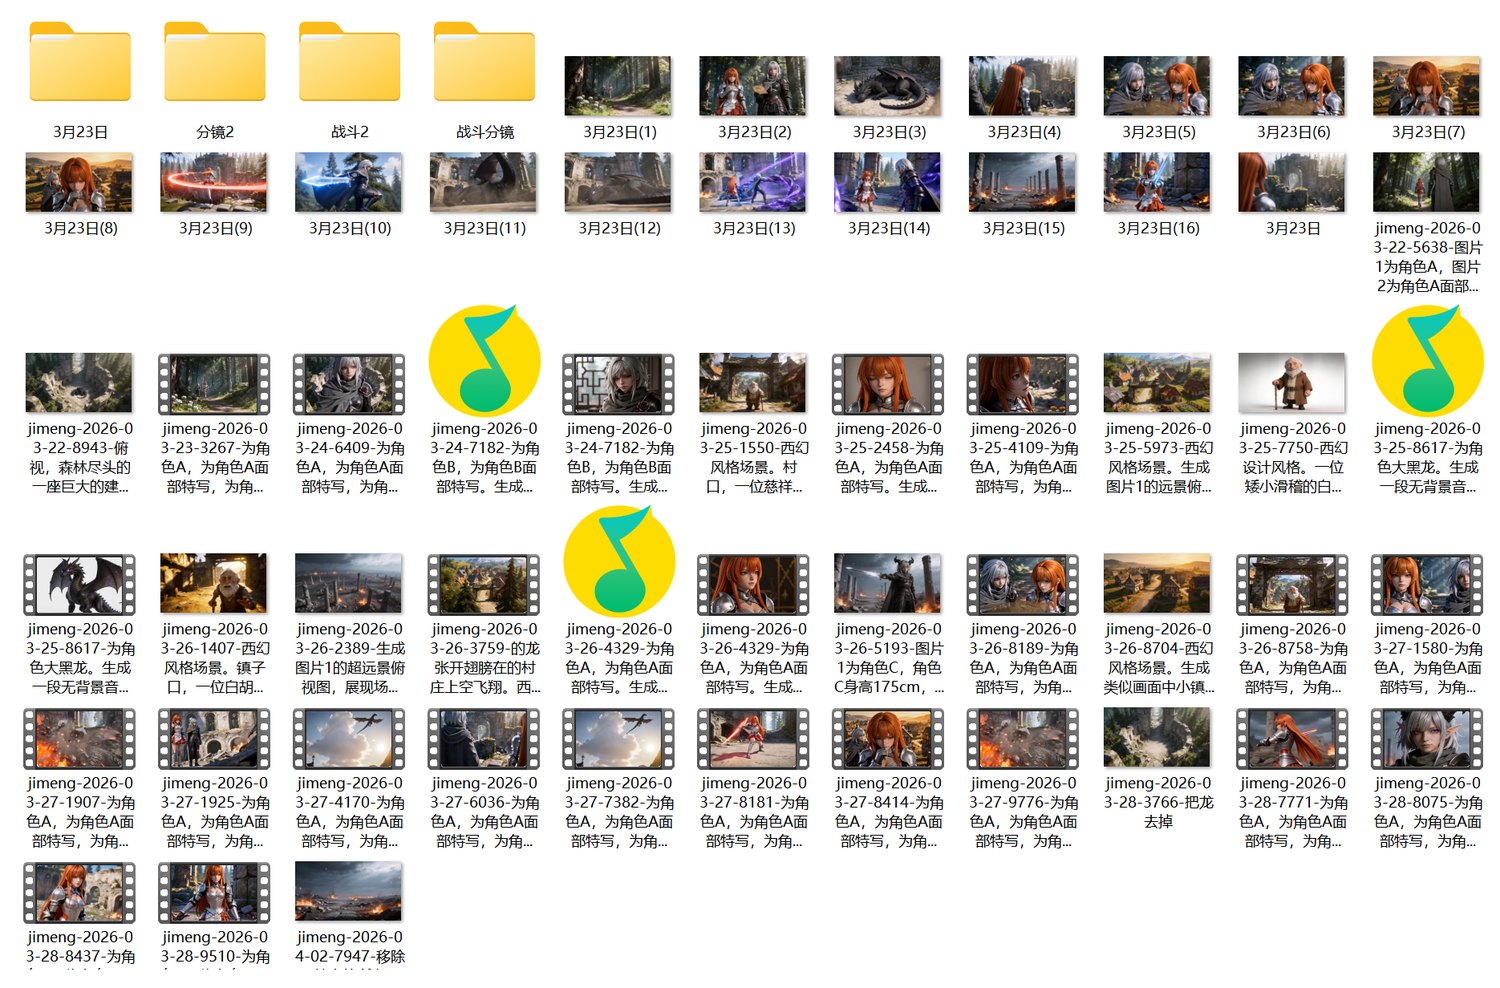
Result / 结果
传统流程里,5 分钟的高质量战斗短片,小团队做好几个月很正常。这次从剧本到成片是一个人、几周。省下来的主要不是画的时间,是无谓试错的时间。
Findings / 踩过的坑
这些不是查资料得来的,是反复生成失败之后自己撞出来的。每条后面都跟着一次具体的翻车。
只支持人形、猫、狗三种模板。拿狗的模板套龙,绑定之后后腿和尾巴是粘在一起的,骨架也错位。非常规生物只能手动绑,多花几个小时,但省不掉。
单张分镜图进去,模型把它理解成“目标构图”,前后的动作它自己编。把同一段分镜做成几秒的参考视频,动作时序和角色相对位置才对得上。
两个角色同时出现,光给两张参考图不够。真发生过发型和服装互换。后来每个角色锚一个名字,提示词里统一用它指代,才不再混。
铠甲破损前后、施法变身前后,叙事上是同一个人,提示词里要当成两个角色,各备一套参考图。否则模型会在两套形象之间做插值,两边都失真。
一条片子里只给其中一个镜头写运镜、其他不写,生成结果的切换节奏反而会乱、视角会错位。要么每个镜头都写清楚,要么一个都别写。
画面在时间轴上从复杂、个性化走向简单、常见时,生成最稳。所以倒放能出一些正向生成拿不到的效果——倒过来看,时序正好是这个方向。